sales@itmegastar.com
 +7 (923) 252-33-23

Речевая аналитика за прилавком, либо когда AI не справляется
Мы все сейчас возлагаем на AI (ИИ) большие надежды и ждём, что он кардинально изменит нашу жизнь. Но очень часто очарование искусственным интеллектом либо даже «сверхинтеллектом» заканчивается закономерным разочарованием. Тем не менее наша жизнь уже меняется: что-то внедряется успешно, что-то нет. Почему так — посмотрим на примере одного из проектов.
Задача, которая выглядела простой
В 2026 году в Новосибирске вместе с нашими партнёрами из «Гастрогнома» (это сеть из более чем 40 магазинов сибирских фермерских продуктов с прилавочной торговлей) мы начали проект по речевой аналитике диалогов продавцов с покупателями за прилавком. И, казалось бы, чего тут сложного и почему такого ещё никто по-нормальному не сделал? Но всё по порядку.
Прежде всего, это уже работающий бизнес-процесс: рядом с кассовым аппаратом и так стоит китайская видеокамера, которая пишет звук и отправляет записи куда-то на китайский сервер, откуда их можно прослушать через мобильное приложение. Этим периодически занимаются специально обученные люди, которые следят за качеством обслуживания покупателей.
Даже выборочная проверка записей — очень трудозатратный процесс, который хочется автоматизировать. Тем более что сейчас для многих CRM-систем уже есть транскрибация (перевод устной речи в текст) записей телефонных разговоров, а AI-диктофон вроде Plaud Note плотно вошёл в обиход многих людей.
Задача простая — перевести записи диалогов в текст, а потом проанализировать их с помощью LLM (искусственного интеллекта). Кажется, в 2026 году такой сервис можно навайбкодить за неделю-две.
Мы пошли именно таким путём: дали задачу обычному программисту и стали ждать результата. Человек взялся за задачу, быстро связался с китайскими товарищами, получил от них API (программный интерфейс) для скачивания записей и начал писать сервис, после чего встал наглухо. Почему так?
Почему всё встало
Есть ряд проблем, которые надо решать по ходу.
- Тяжёлые видеоВидеозаписи много весят. Их надо куда-то скачать, чтобы потом предобработать: оставить только звуковую дорожку и почистить звук. Но для этого уже нужно подключать S3-хранилище (файловое хранилище) и закачивать объёмные файлы из Китая по очень узким каналам связи. Долго и ненадёжно.
- Грязный звукЗвук нормально почистить не получится. Это в телефонном звонке очень чистый звук без фоновых помех и отдельный канал связи для каждого из абонентов. При расшифровке видеовстреч — аналогично. А тут прилавок и много соседних магазинов. Вокруг одновременно говорит множество людей. Не в микрофон, а как получится.
- Ошибки распознаванияСами нейросети, которые занимаются расшифровкой, дают не очень качественный результат. Причём очень «не очень». Да, какие-то модели распознают лучше, какие-то хуже, но у всех есть заметные глазу ошибки.
- Иллюзия идеальной расшифровкиОказывается, у людей есть иллюзия, что если они качественно обработают звук, то получат качественную расшифровку, которую потом качественно обработает LLM (большая языковая модель, такой класс нейросетей). А это не так.
И это только первый пласт проблем, которые надо решить. Однако именно это препятствие не преодолевается вайбкодерами и рядовыми программистами.
Не хватает инженерного подхода.
Свой микрофон вместо камеры
В итоге оказалось, что китайские товарищи быстро подсуетились и сделали использование своего API платным. То есть вариант с расшифровкой данных с камеры стал просто нерентабельным.
Выход мы нашли быстро: взяли плату с микрофоном и Wi-Fi для голосовых ассистентов — ESPHome Assistant ReSpeaker Lite Kit-USB 2 Mic Array.
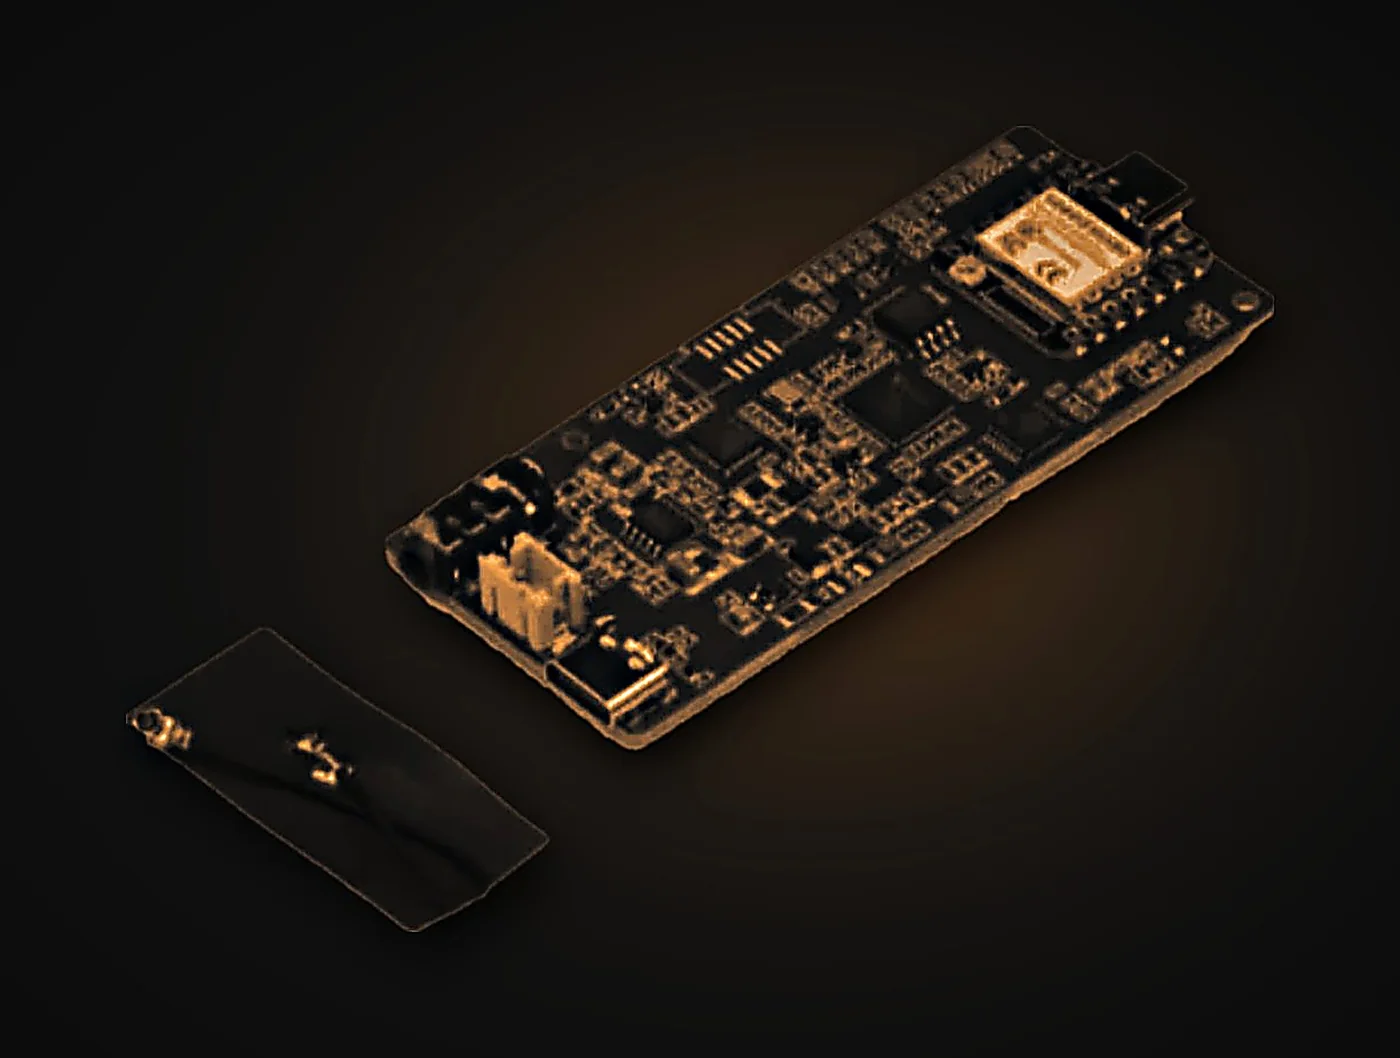
Логика решения очень простая. Есть умные колонки, которые решают очень похожую задачу. Они ждут, пока человек к ним обратится, передают запись разговора на облачный сервер, где её расшифровывают, готовят и озвучивают ответ, после чего колонка просто проигрывает полученную из облака запись.
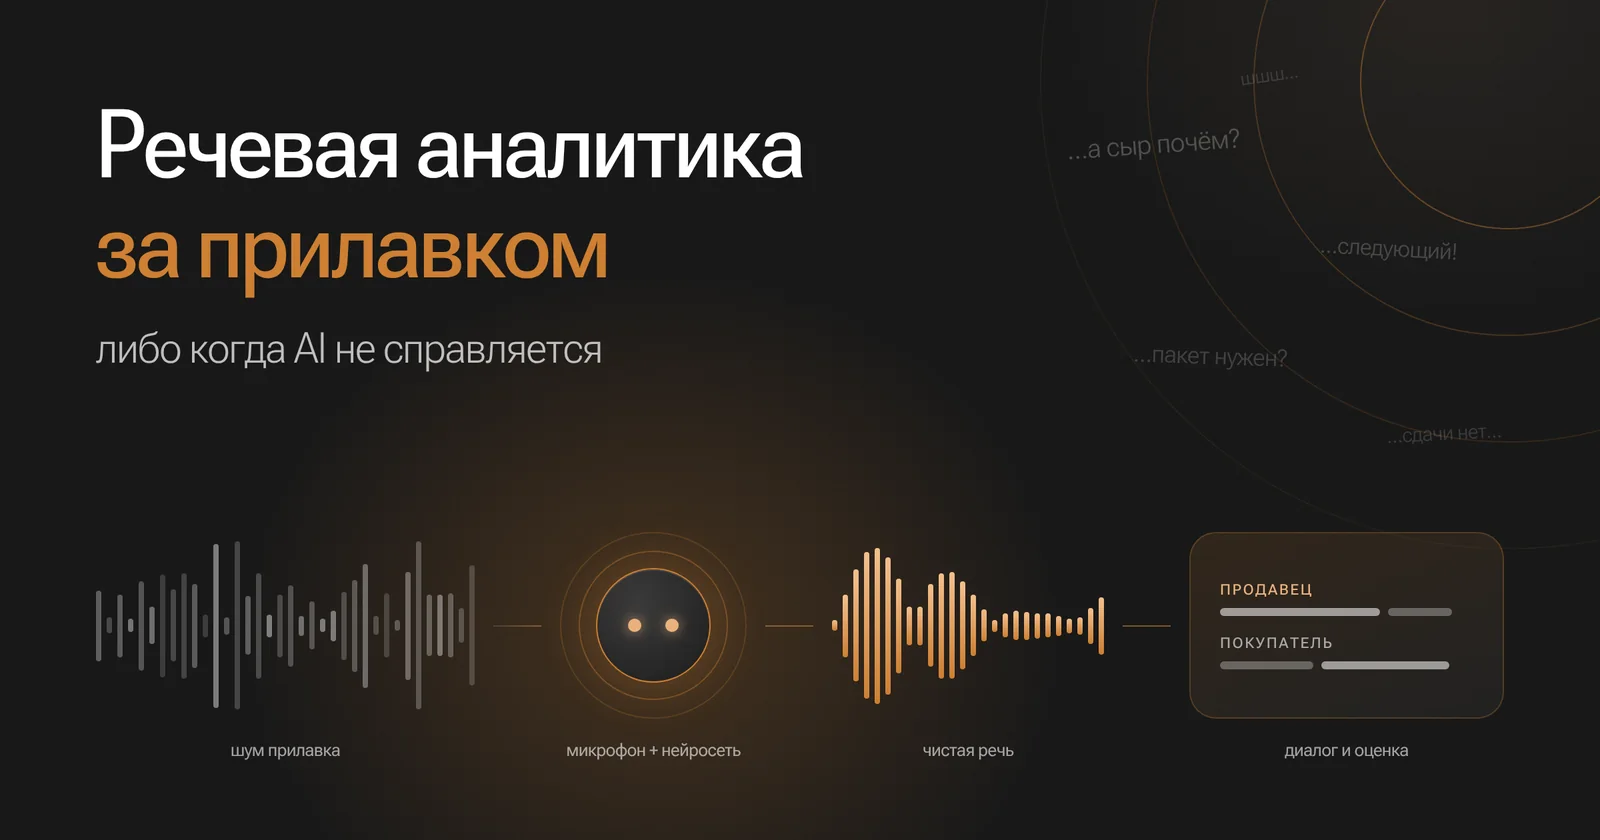
Хотелось, чтобы микрофон сам отделял внешние шумы от реальных диалогов с покупателями и отправлял готовые звукозаписи на сервер для расшифровки. Благо у него есть модуль Wi-Fi.
Конечно, такую плату за прилавок не положишь: она хрупкая и непрезентабельная. Ей нужен корпус, который можно напечатать на 3D-принтере, но есть и другое решение — ReSpeaker XMOS XVF3800 с XIAO ESP32S3.
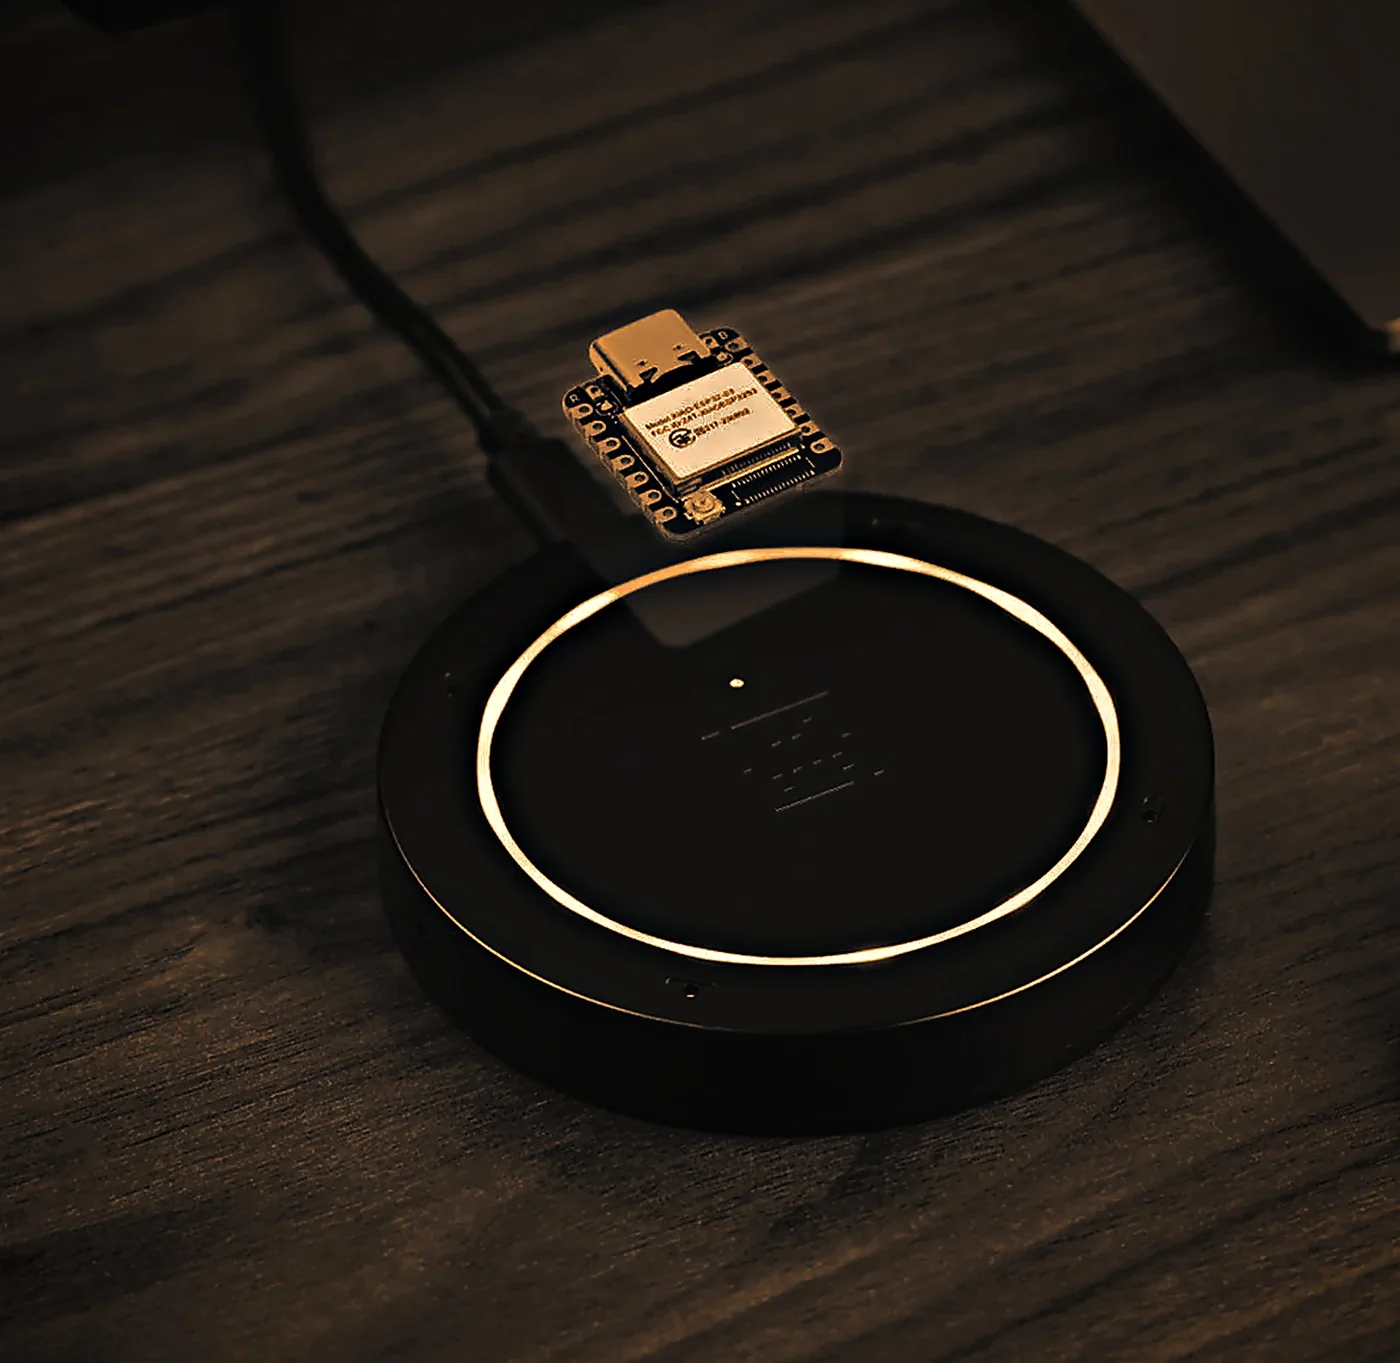
По сути, это то же самое, но с четырьмя микрофонами и в корпусе. Пока ждём, когда устройство приедет к нам из Китая.
Но вернёмся к ReSpeaker Lite. Мы написали для него прошивку, которая давит шумы и эхо, выравнивает звук и с помощью локальной нейросети отделяет разговоры людей от всего остального, после чего отправляет их на сервер.
На борту там небольшой DSP-процессор. Мы пробовали играть с амплитудно-частотными характеристиками, порогами и прочим, но маленькая нейросеть оказалась эффективнее.
И работает это всё… Ну, как-то работает, конечно.
Поэтому на стороне принимающего сервера стоит каскад ещё из двух более мощных нейросетей, которые дочищают полученные записи от мусора. Мы поставили это устройство у себя в офисе на недельку, чтобы протестировать и отладить.
Что можно сказать? Фактически мы изобрели Plaud Note. Классно пишет разговоры, расшифровывает речь и делает саммаризацию. Это примерно тот уровень, до которого может дойти хорошая команда программистов.
Полевые испытания
А потом мы отправили испытательный стенд на полевые испытания за прилавок — туда, где много посторонних шумов и параллельных фоновых диалогов. Качество расшифровок записей серьёзно упало.
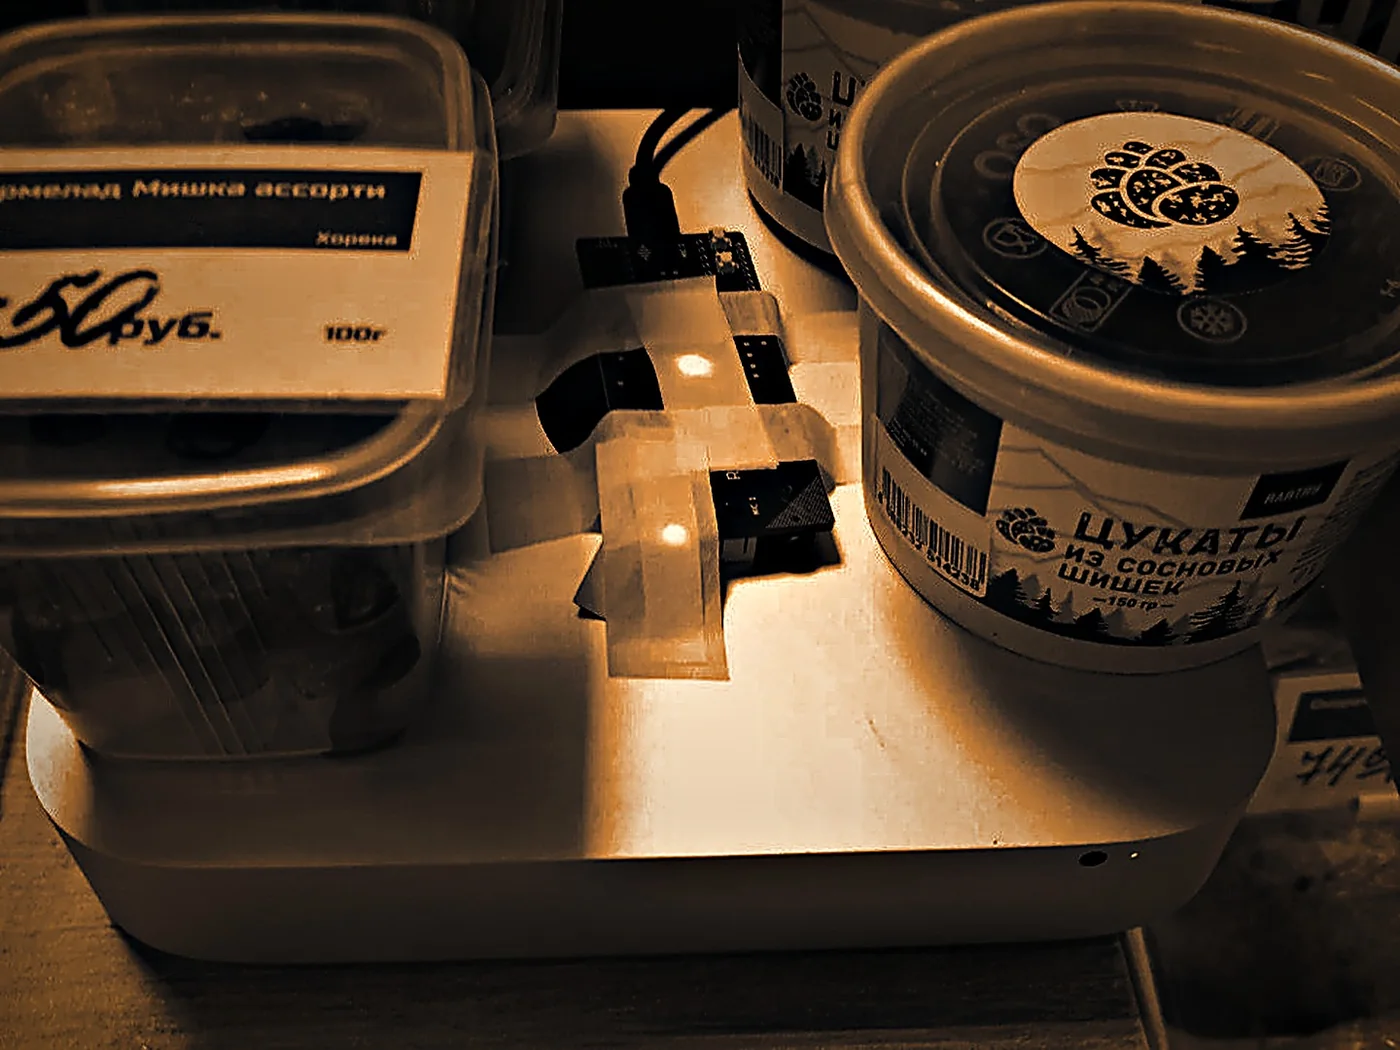
Это ожидаемый этап отладки прошивки и поиска новых порогов, но уже на базе данных с полевых испытаний. Мы же понимали, что тот же Plaud Note с нужной задачей не справится.
Данные с «поля» позволили не только отладить прошивку устройства, но и вскрыли несколько проблем. Например, очевидно, что разделять диалоги с покупателями мы будем по длительной паузе. Однако есть два момента, которые следует учитывать:
- Следующий покупатель начинает разговаривать с продавцом сразу же после покупателя, с которым уже попрощались.
- Пока продавец и покупатель уходят к прилавку и выбирают товар, будет большая пауза.
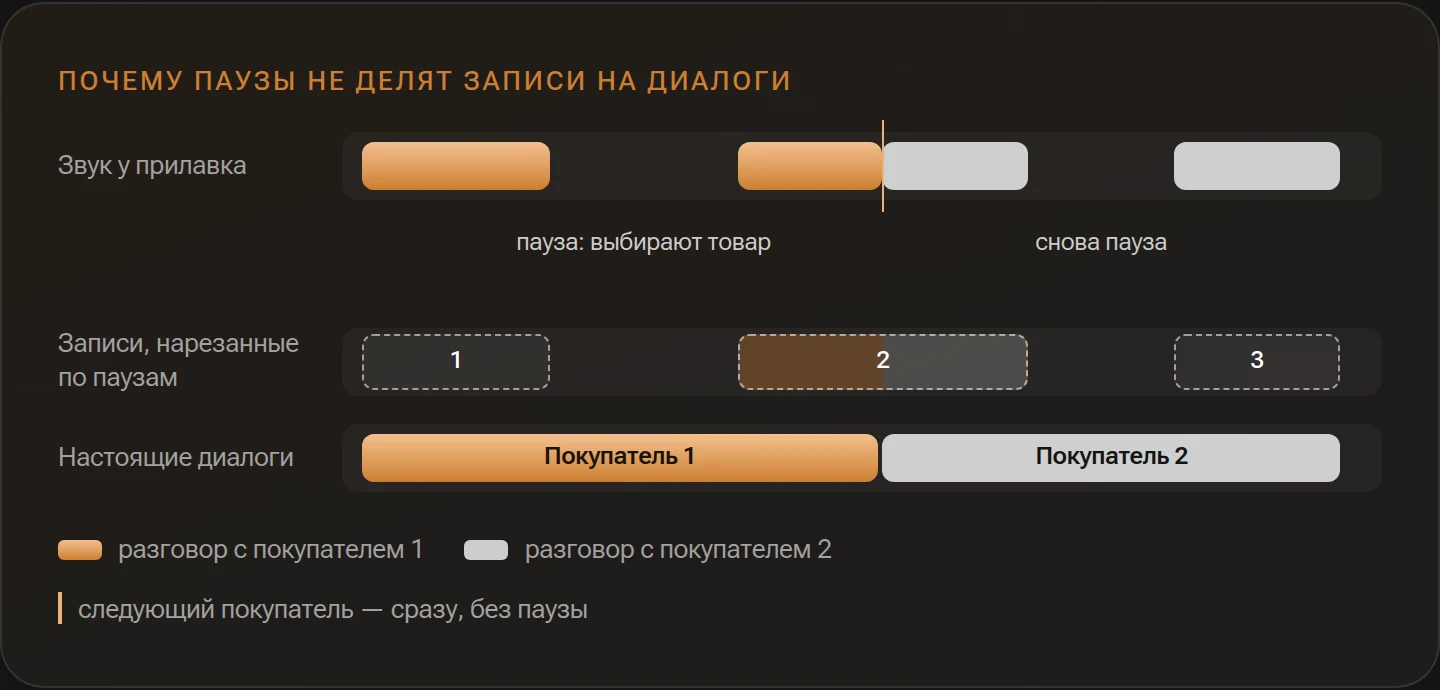
Значит, будет много записей, где диалог начинается с середины, а ещё в них может присутствовать начало следующего диалога. То есть после расшифровки все эти записи надо разделить и пересобрать в нормальные диалоги, прежде чем вообще отдавать их на анализ и оценку.
И этим тоже занимается нейросеть, но уже облачная. Модель такой нейросети нужно подбирать по соотношению цена/качество. С одной стороны, модель должна быть достаточно мощной и не галлюцинировать, а с другой — не убивать экономическую целесообразность всей инициативы.
И только потом можно анализировать день работы магазина, проверять, где продавцы нарушают стандарты обслуживания, и выставлять оценки. Но это уже следующая часть полевых испытаний.
Сколько это стоит
- устройствоМикрофон за прилавкомDSP и маленькая нейросеть давят шум и эхо, выделяют речь
- наш серверДочистка записейКаскад из двух нейросетей убирает оставшийся мусор
- облакоРаспознавание речиmai-transcribe-2 переводит звук в текст
- облакоДеление на продажиclaude-haiku-5.5 пересобирает записи в диалоги
- облакоРолиgpt-4.1-mini определяет, где продавец, а где покупатель
- облакоОценка по чек-листуclaude-haiku-5.5 проверяет стандарты обслуживания
Пока что стоимость обработки одного дня с одного прилавка составляет 121,9 рубля:
| Этап | Модель | Объём | Стоимость |
|---|---|---|---|
| Распознавание речи | mai-transcribe-2 | 148,7 мин | 49,56 ₽ |
| Деление записей на продажи | claude-haiku-5.5 | — | 14,63 ₽ |
| Определение ролей продавец/покупатель | gpt-4.1-mini | — | 8,82 ₽ |
| Оценка продаж по чек-листу | claude-haiku-5.5 | 129 запросов | 48,87 ₽ |
| Итого за день с одного прилавка | 121,9 ₽ | ||
Подводя итоги
Если честно, речевая аналитика за прилавком оказалась совсем не той задачей, какой казалась на старте. Перевести звук в текст и отдать нейросети — это только видимая часть. Под ней железо, прошивка, каскад нейросетей, пересборка записей в диалоги и постоянный подсчёт денег, чтобы вся инициатива не превратилась в убыточную игрушку.
Если совсем коротко, разница выглядит примерно так:
- Рядовой программист или вайбкодер берёт API, начинает писать сервис и встаёт наглухо на первом же пласте проблем.
- Хорошая команда программистов доходит до уровня Plaud Note: в офисе всё классно пишется, расшифровывается и саммаризируется. За прилавком — уже нет.
- Инженерный подход начинается с вопроса, какие данные на самом деле нужны AI. Дальше задача раскладывается на шаги, и под каждый шаг подбирается своя нейросеть по соотношению цена/качество.
То есть AI не справляется, когда от него ждут волшебной кнопки: закинул записи — получил оценки. И справляется, когда ему дают посильную работу. Ни одна нейросеть в нашем каскаде не идеальна, но вместе они дают рабочий результат. Причём с понятной ценой — 121,9 рубля в день на один прилавок.
Впереди следующая часть полевых испытаний: оценка продаж по чек-листу на реальных данных и устройство на XVF3800, которое пока едет к нам из Китая. Чем всё закончится, расскажу в следующей статье.
Если вы дочитали до конца и написанное было для вас полезным, то спасибо вам.