sales@itmegastar.com
 +7 (923) 252-33-23

Речевая аналитика за прилавком: проверяем локальные модели
Пока к нам едет новый микрофон, можно позаниматься промпт-инжинирингом и проверить, получится ли добиться сопоставимых результатов на локальных моделях ASR и LLM при достаточно скромных серверных мощностях. Всё, что у нас есть, — это NVIDIA RTX A5000 с 24 ГБ GDDR6. Посмотрим, что из неё можно выжать.
Это продолжение статьи «Речевая аналитика за прилавком, или Когда AI не справляется».
Как это работает в облаке
Запись разговора попадает на сервер, проходит фильтр на наличие речи, сохраняется в файловое хранилище и ждёт, когда пользователь захочет построить отчёт за день работы точки продаж, где стоит микрофон.
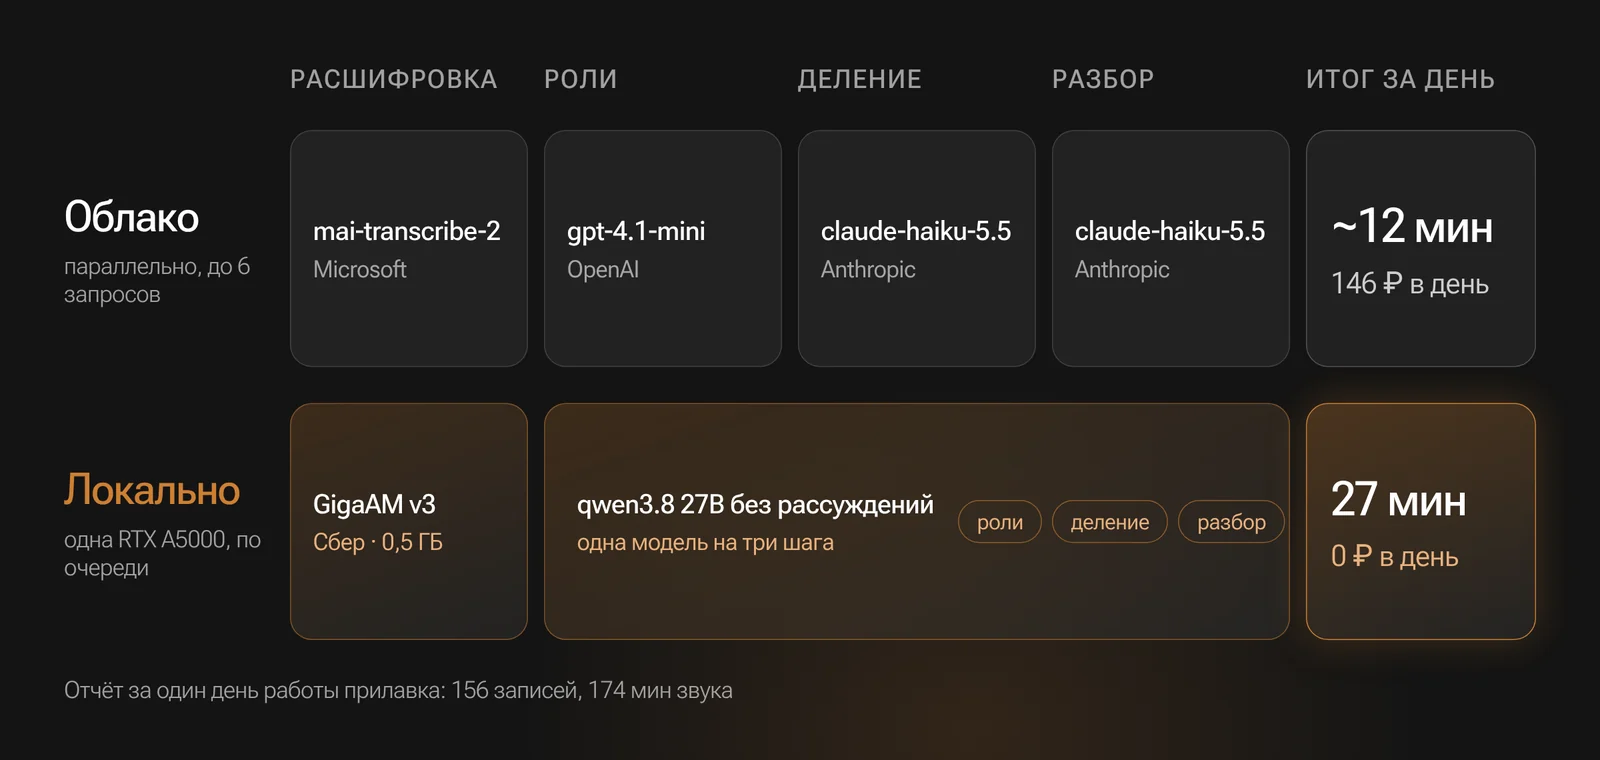
Чтобы построить отчёт, нужно пройти следующие шаги:
- Провести транскрибацию (перевод голоса в текст) записей за день. Это примерно 150–300 мин за один день. Сейчас этим занимается облачная модель от Microsoft — mai-transcribe-2.
- Определить, какой голос принадлежит продавцу, а какие — покупателям. Этим занимается LLM gpt-4.1-mini.
- Разделить записи, в которые попали конец одного диалога и начало другого, а потом склеить диалоги в правильном порядке. Это делает LLM claude-haiku-5.5.
- Провести оценку по чек-листу и составить итоговый отчёт. Здесь тоже работает claude-haiku-5.5.
Облачные модели подбирались по соотношению «цена/качество». Не стоит ожидать от нейросетей постоянного и идеального результата. Их задача — обработать большой объём информации и подготовить оптимальный её объём для анализа человеком.
Зафиксировать отклонение — это только начало. Нужно ещё разобраться в ситуации, в которой оно произошло, и было ли оно вообще, а если было, то что и как исправить. Кроме случаев, когда сотруднику нужно исправить свою работу, бывают и такие, когда надо исправлять скрипты обслуживания либо промпты проверки.
Конечно, более дорогие и совершенные модели дают более высокое качество распознавания речи и анализа диалогов, но качество результата растёт непропорционально себестоимости обработки. Поэтому дороже — не всегда лучше, особенно если дороже стал лишь один из шагов процесса, а итоговый результат лучше не стал.
Какие локальные ресурсы доступны
У нас есть достаточно бюджетное решение начального уровня. Это весьма старая рабочая станция с процессором Intel Core i5-7600 (4 ядра, 3,5 ГГц) и 16 ГБ оперативной памяти, но с NVIDIA RTX A5000 на 24 ГБ GDDR6 на борту.
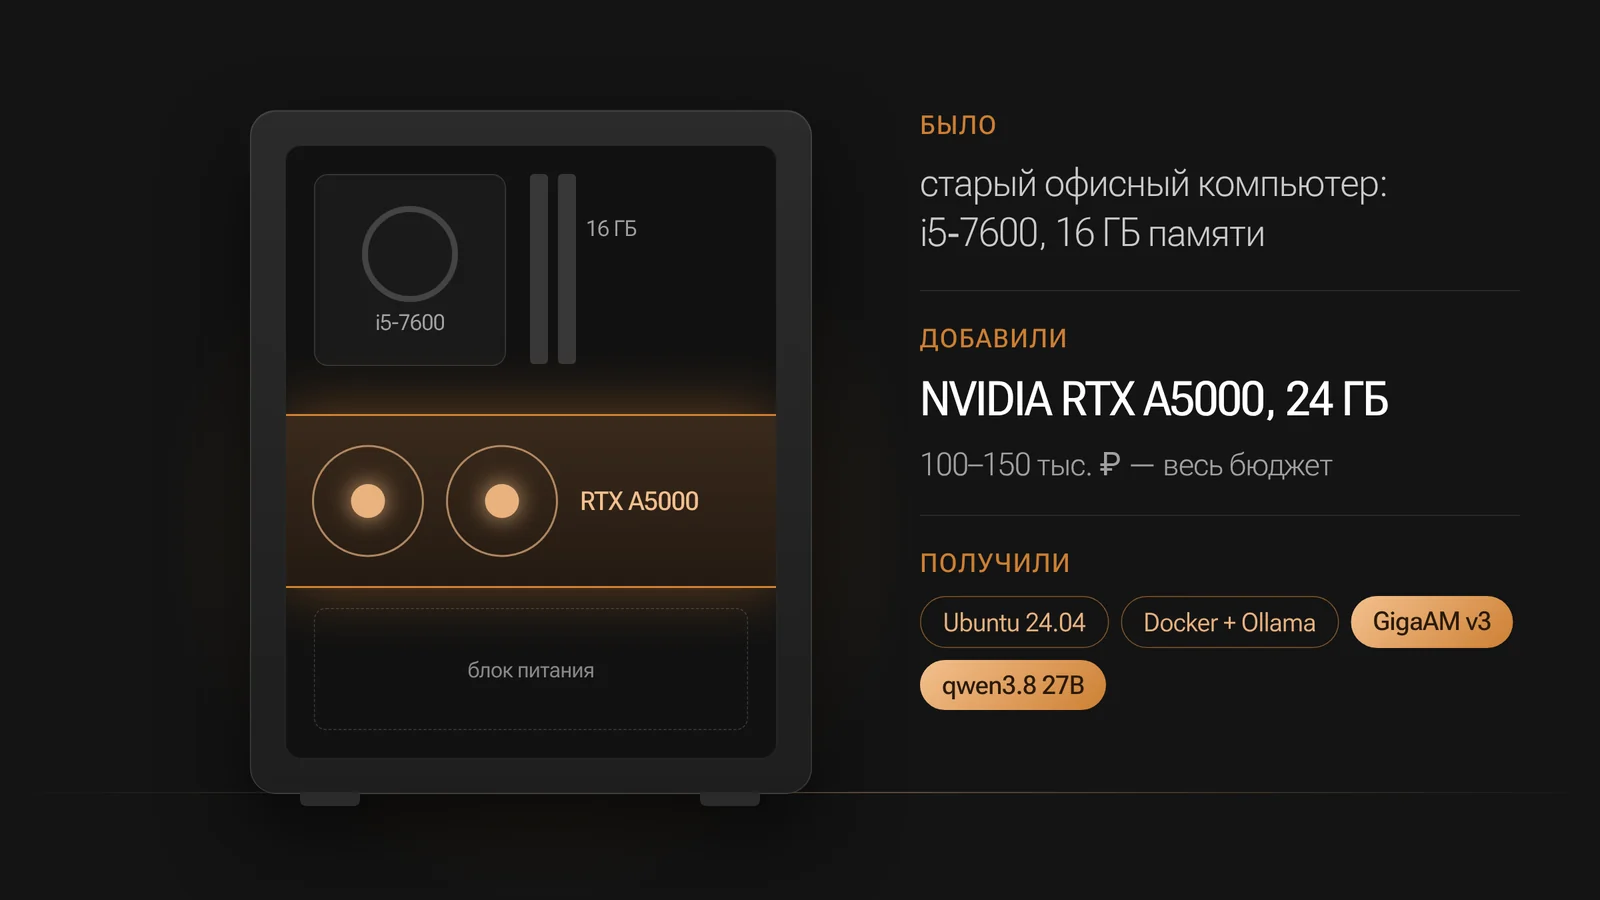
Основная работа LLM всё равно выполняется на GPU и в видеопамяти, поэтому всё остальное — лишь «носитель», через который можно обратиться к видеокарте.
Операционная система — Ubuntu 24.04, драйвер NVIDIA 560.35, CUDA 12.6. Сервер языковых моделей — Ollama 0.40, развёрнутый в Docker.
По сути, это старый офисный компьютер с видеокартой за 100–150 тыс. ₽. Вот и весь бюджет решения…
Какие локальные модели доступны
Проще всего с моделями для транскрибации: обычно они занимают немного места и спокойно умещаются в видеопамять. Для тестов брали:
- GigaAM v3 e2e RNNT (Сбер, ~0,24 млрд параметров; далее — GigaAM) — требует 0,45–0,5 ГБ видеопамяти.
- Whisper large-v3 (далее — Whisper), квантование int8 и float16 — требует до 2,3 ГБ при int8 и до 4,1 ГБ при float16.
- Qwen3-ASR-0.6B (Alibaba) — требует 1,8 ГБ.
Кроме транскрибации, нужна ещё и LLM. На самом деле 24 ГБ видеопамяти — это очень мало, поэтому выбор невелик:
- qwen3.8 27B, квантование Q4_K_M — требует от 17,7 ГБ.
- gemma4 31B, квантование Q4_K_M — требует от 20,4 ГБ.
- qwen3-30b-instruct, квантование Q4_K_M — требует от 18,6 ГБ.
- gemma3 27B, квантование Q4_0 (QAT) — требует от 18,1 ГБ.
- mistral-small3.2 24B, квантование Q4_K_M — требует от 15,2 ГБ.
То есть в 24 ГБ видеопамяти вполне умещаются ASR, LLM и ещё какая-нибудь модель для расчёта эмбеддингов для RAG. Но LLM будет скромной.
Методика сравнения
У нас уже были отчёты, построенные с помощью облачных моделей, подобранных по соотношению «цена/качество». Оставалось только попробовать разные варианты транскрибации и обработки диалогов через LLM. Иногда для сравнения использовались данные от более дорогих и продвинутых облачных моделей.
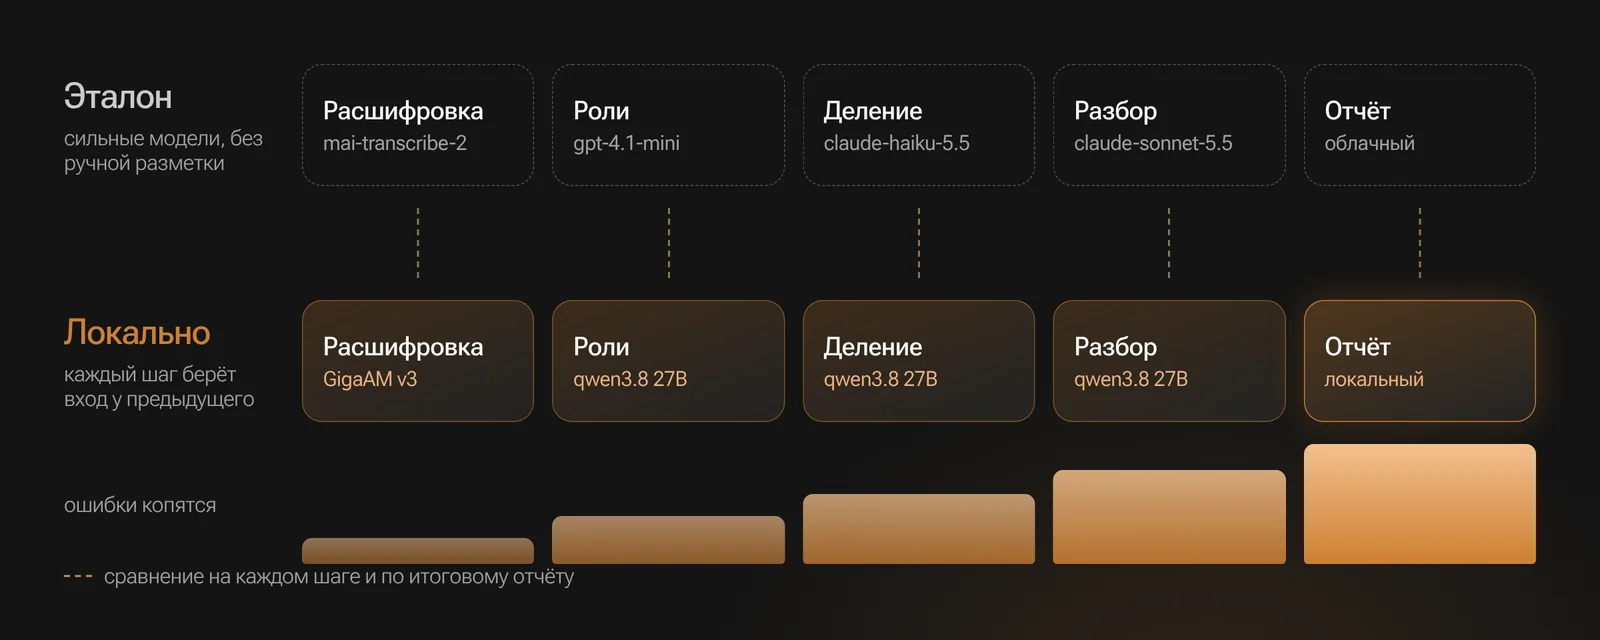
Важный момент: переход на локальные модели происходил последовательно. То есть локальная LLM получала на вход транскрибацию от локальной модели, которая может работать хуже облачной. Сравнивались как результаты на каждом шаге обработки, так и итоговый отчёт.
Фактически проверялось, насколько можно приблизиться к результатам облачных моделей при их полной замене на локальные. То есть ошибки моделей с предыдущих этапов накапливались и занижали результаты локальной модели на её этапе.
Это не совсем корректное сравнение самих моделей, но корректный подход с точки зрения бизнеса, которому нужны результаты, а не синтетические тесты. Впрочем, напрямую модели тоже сравнивались в процессе отбора, но эти данные приводить здесь не будем.
Ещё один важный момент: ручной разметки никто не делал. Все сравнения производились на основе данных от более продвинутых моделей. Это тоже необходимо держать в голове.
Метрики для сравнения:
- Расшифровка: объём текста относительно облачного (медиана), доля ошибок в словах (WER), доля найденных ключевых фраз прилавка («пакет нужен», «бонусы», «всего доброго»), лишние вставки ключевых фраз, мусорные строки вроде «Продолжение следует».
- Деление и склейка: общая оценка по разрезам и склейкам от 0 до 1, учитывает и пропуски, и лишние элементы.
- Разбор: совпадение оценок правил с эталоном; точность предупреждений (сколько из них — настоящие нарушения) и полнота (какую долю настоящих нарушений они находят).
Распознавание речи на локальных моделях
Здесь уместно напомнить, что тестирование идёт на данных прилавочной торговли. Это сложные и сильно зашумлённые данные. Перед полевыми испытаниями мы делали записи у себя в офисе: там звук получался куда чище, и качество распознавания было выше. Если расшифровывать телефонные переговоры, качество распознавания будет ещё выше.
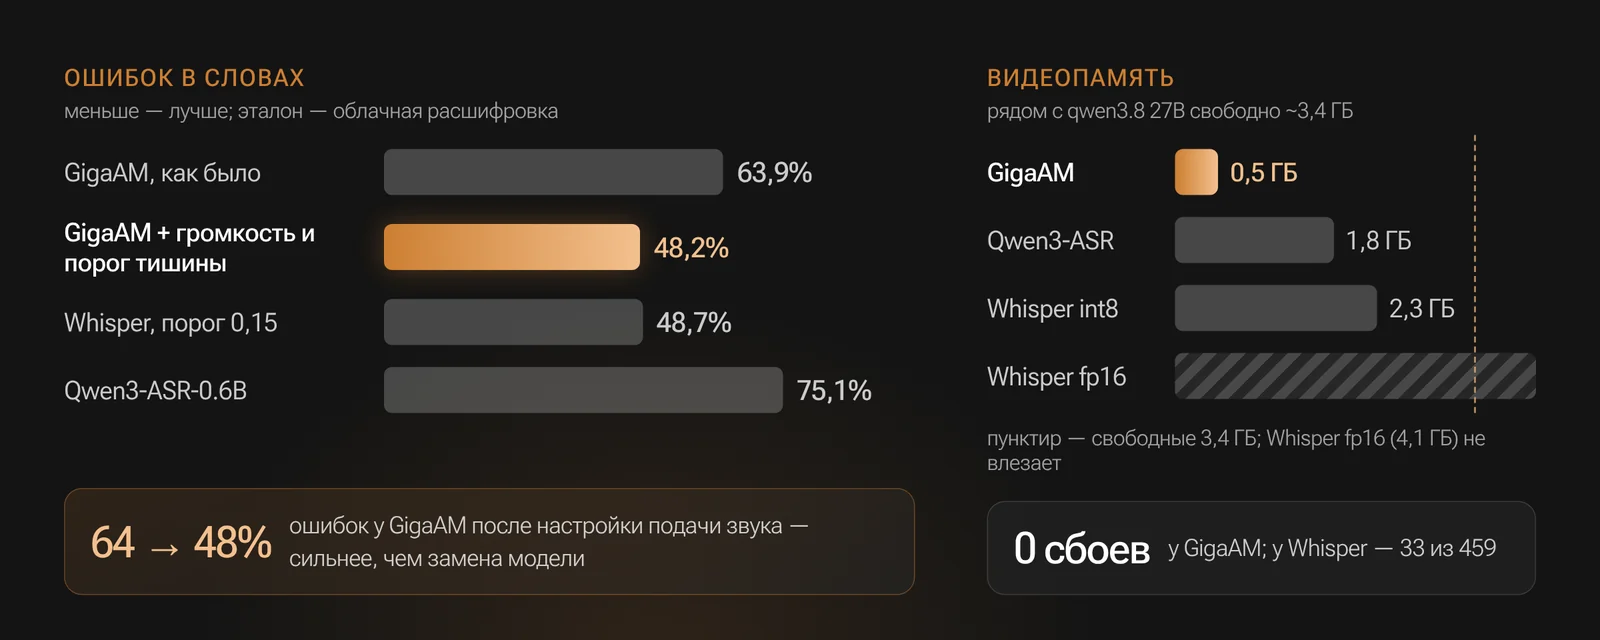
При подборе многое зависит не только от самой модели, но и от её настроек. Например, многие модели позволяют использовать словари лексики, которые повышают качество распознавания. А у нас как раз была возможность собрать такие словари по записям за неделю работы точки продаж. Благодаря таким словарям нейросеть должна работать точнее.
В нашем случае это не подошло. Например, Whisper начинает делать ложные вставки: ему слышатся «акции» и «пельмени» там, где их не было. Для проверки продавца это хуже пропуска: ему засчитают предложение, которого не было. Qwen3-ASR-0.6B со словарём просто вписывает подсказку в текст: 904 лишние фразы.
Другой важный параметр — порог тишины, иначе говоря, уровень громкости звука, ниже которого нейросеть просто не берётся за распознавание. На этом теряется часть данных по диалогам.
Ниже — сравнение на 123 записях за один из дней, которые прошли во всех вариантах. Эталоном служила облачная расшифровка.
| Модель и настройки | Объём к облаку | Ошибок в словах | Ключевые фразы | Лишние фразы | Мусор | Сбои |
|---|---|---|---|---|---|---|
| GigaAM, первоначальные настройки | 43% | 63,9% | 45,8% | 12 | 0 | 0 |
| GigaAM + громкость, порог 0,15 | 68% | 48,2% | 68,9% | 29 | 0 | 0 |
| Whisper, порог 0,15 | 81% | 48,7% | 70,4% | 36 | 26 | 6 |
| Whisper, порог 0,15 + словарь | 76% | 49,1% | 71,4% | 66 | 34 | 7 |
| Whisper, порог 0,3 | 77% | 50,1% | 65,7% | 35 | 18 | 0 |
| Qwen3-ASR-0.6B | 73% | 75,1% | 39,4% | 34 | 0 | 17 |
| Qwen3-ASR-0.6B + словарь | 86% | 96,7% | 56,9% | 904 | 0 | 17 |
Объём — текст относительно облачной расшифровки (медиана). Ключевые фразы — доля найденных; лишние — ложные вставки. Сбои — записи, на которых модель упала.
Прогоны за несколько дней показали следующее:
- Порог тишины оказывает заметное влияние. Изначально GigaAM не расшифровал 24 записи совсем. Пики в них были от −23 до −44 dBFS, средний уровень — около −56 dBFS. После подъёма громкости до пика 0,7 и снижения порога отсечения тишины с 0,4 до 0,15 доля ошибок упала с 64% до 48%.
- Отказ от порога тишины делает только хуже. Текста не прибавляется, а мусорных строк у Whisper становится вдвое больше.
- GigaAM и Whisper почти вровень по качеству. Whisper даёт больше текста и лучше слышит «спасибо» (87 из 135 против 67). GigaAM лучше слышит «всего доброго» (20 из 31 против 13) и не пишет мусор вроде «Продолжение следует» и «Субтитры…».
- GigaAM занимает около 0,5 ГБ и ни разу не упал. Whisper в int8 на пике берёт 2,3 ГБ и рядом с qwen3.8 27B падает: из 459 прогонов 33 завершились ошибкой (нехватка памяти и cudaErrorInvalidDevice). Float16 в свободные 3,4 ГБ не влезает даже с beam 2.
- Потолок задаёт звук. «Спасибо» и «до свидания» теряются не из-за незнакомых слов, а потому что их почти не слышно: покупатель стоит далеко от микрофона. Настройками модели это не исправить.
В итоге лучшие результаты показывает GigaAM — и по качеству работы, и по расходу памяти. Команда Сбера сделала прекрасный инструмент для ASR, которому не нужно какое-то особое оборудование.
Честно говоря, по-моему, это хорошо показывает будущее развитие нейросетей. В какой-то момент гонка размеров должна закончиться, и нейросети начнут наращивать эффективность. GigaAM уже можно запускать на обычном компьютере. Возможно, её уже можно эффективно использовать и на смартфоне.
Пара слов о рассуждающих моделях
Звучит оно, конечно, гордо и прекрасно, но, как показала практика, скептицизм зрелого IT-специалиста более чем обоснован. Лично я очень не люблю «слишком интеллектуальные системы». Ещё со времён Windows Millennium Edition хорошо известно свойство таких систем: они либо работают хорошо и из коробки, либо не работают, и ты с этим ничего не можешь сделать.
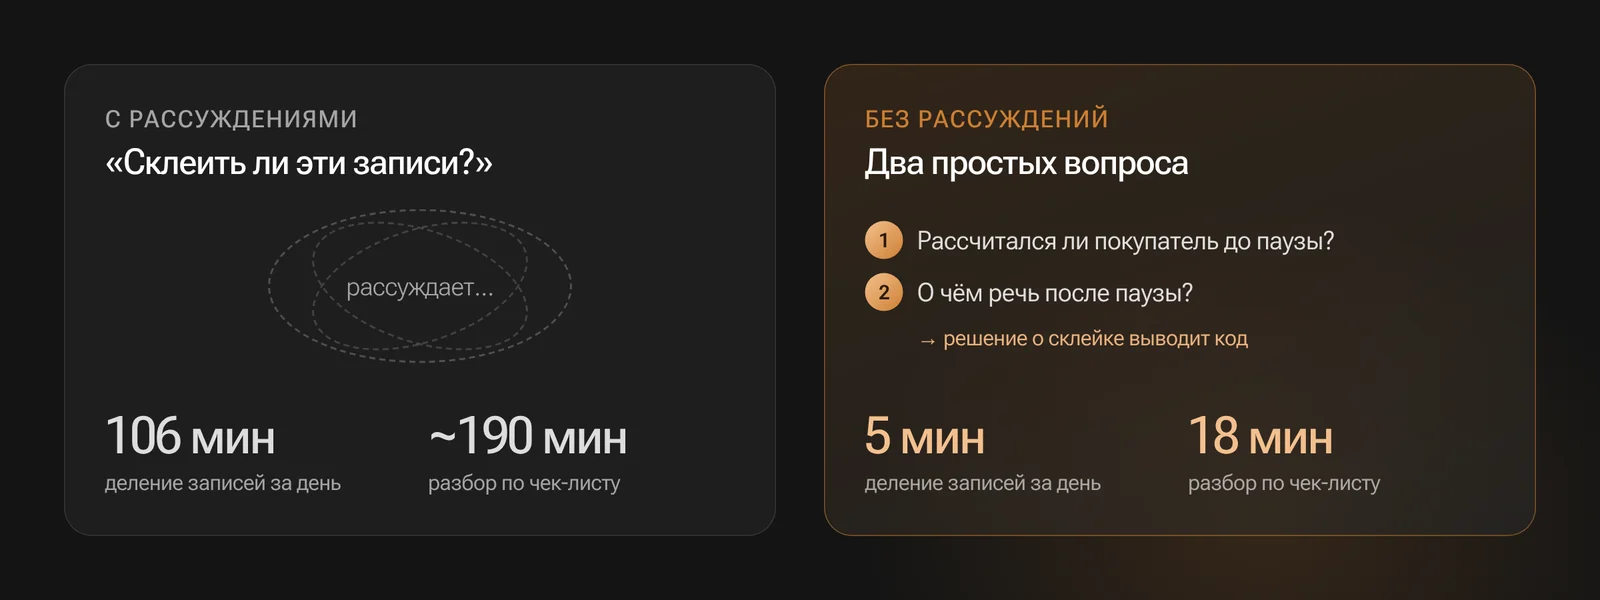
Так и с «рассуждениями» моделей. Если модель начинает рассуждать «неправильно», повлиять на это бывает очень сложно. С другой стороны, модели без рассуждений позволяют самому строить цепочки принятия решений, которые будут работать не хуже «рассуждений» моделей.
Большая часть позитивного опыта простых пользователей с AI связана не с качеством работы LLM, а с качеством алгоритмов, сценариев диалогов, слоёв знаний и выводов и многого другого, что команды разработчиков вложили в свои AI-ассистенты и AI-агенты.
Например, я сейчас предпочитаю работать с Claude Code от Anthropic, а Codex от OpenAI кажется мне более слабым решением. И дело не в моделях, а в самих командах разработки этих компаний, которые я чувствую сквозь AI-агенты и AI-ассистенты.
Или, скажем, для себя я предпочитаю Perplexity и вообще не думаю о том, какие модели он использует. Почему так получилось? Во-первых, он стабильно работает без VPN — мне так просто удобнее. Во-вторых, я уже сам адаптировался под этот инструмент: изначально и незаметно для себя ставлю вопрос так, чтобы получить от Perplexity хороший результат.
На каком-то этапе подбора моделей qwen3.8 27B с рассуждениями показала очень плохие результаты, поэтому в рассмотрение были добавлены модели без рассуждений. Однако после оптимизации промптов под локальные модели оказалось, что qwen3.8 27B с рассуждениями может выдавать пристойные результаты.
Разделение и склейка диалогов
Одна запись у кассы может содержать несколько диалогов с покупателями — тогда её нужно разделить. В то же время один диалог может занимать фрагменты разных записей, например из-за длинных пауз при выборе товара за прилавком. Поэтому нужна склейка фрагментов записей в диалоги.
Ниже — сравнение на 153 записях за один из дней работы точки продаж. Все модели получали облачные расшифровки диалогов.
| Модель и промпт | Время на день | Разрезы: оценка | Разрезы: найдено / лишних | Склейки: оценка | Склейки: найдено / лишних |
|---|---|---|---|---|---|
| claude-haiku-5.5 (облако) | ~2 мин, ~20 ₽ | 0,73 | 37 из 49 / 15 | 0,81 | 34 из 45 / 5 |
| qwen3.8 27B с рассуждениями | 106 мин | 0,80 | 41 / 13 | 0,76 | 29 / 2 |
| qwen3.8 27B без рассуждений, промпт сервиса | 4,8 мин | 0,81 | 39 / 8 | 0,12 | 3 / 0 |
| qwen3.8 27B без рассуждений, новый промпт | 5,1 мин | 0,82 | 40 / 7 | 0,80 | 30 / 0 |
| gemma4 31B, новый промпт | 10,7 мин | 0,86 | 44 / 9 | 0,69 | 24 / 1 |
| gemma4 31B, промпт сервиса | 10 мин | 0,84 | 44 / 12 | 0,55 | 17 / 0 |
| qwen3-30b-instruct, промпт «продажи с расчётом» | 3,3 мин | 0,51 | — | 0,72 | 30 / 8 |
| mistral-small3.2 24B, qwen3-30b-instruct, gemma3 27B — промпт сервиса | 2,5–7 мин | 0,36–0,43 | 26–31 / 59–84 | ≈0 | 0–1 / 0 |
Оценка — от 0 до 1, учитывает и пропуски, и лишнее. Всего в эталоне 49 разрезов и 45 склеек.
Что тут скажешь: когда qwen3.8 27B с рассуждениями обрабатывает данные 106 мин против 2 мин у claude-haiku-5.5, понимаешь, насколько сильнее платные облачные модели и насколько бесперспективно пытаться перенести всю обработку на локальные.
Однако если не опускать руки преждевременно и оптимизировать промпты, на той же qwen3.8 27B время обработки можно сократить до 5 мин. С одним важным уточнением: claude-haiku-5.5 можно слать много параллельных запросов, а с qwen3.8 27B на нашем оборудовании можно работать только последовательно — на большее не хватает видеопамяти.
По итогам замеров получаем:
- Главные различия между моделями проявляются на склейке. На первоначальном промпте, оптимизированном под облачную модель, модели без рассуждений почти не склеивают: от 0 до 3 из 45.
- Помогла доработка промпта. Вместо вопроса «склеить ли?» модель отвечает на два простых вопроса. Рассчитался ли покупатель до паузы, судя только по строкам до неё? О чём речь после: оплата, товар, новый покупатель или посторонний разговор? У qwen3.8 27B склеек стало 30 вместо 3.
- Главная ошибка старого промпта: сумму и бонусы в начале новой записи модель принимала за признак закрытой продажи. Теперь это отдельный вариант ответа — «оплата той же продажи».
На разделении записей gemma4 31B и qwen3.8 27B показывают даже лучшие результаты, чем облачная модель. Однако qwen3.8 27B лучше склеивает записи, поэтому остаётся она.
Проверка диалогов по чек-листу
Дальше предстоит проверить локальные модели на оценке диалогов по 15–16 правилам. По каждому правилу модель принимает решение «выполнено / не выполнено / не применимо» и проставляет уровень уверенности в своём решении. Уверенное нарушение становится предупреждением, которое отправляется на проверку человеку.
Ниже — сравнение на 146 диалогах за один из дней работы точки продаж, использовались облачные расшифровки записей.
| Вариант | Время на день | Пригодность совпала | Оценки совпали | Предупреждений (верных) | Средний балл |
|---|---|---|---|---|---|
| claude-haiku-5.5 (облако) | ~7 мин, 61,5 ₽ | 99% | 85,4% | 12 (25%) | 87,1 |
| claude-sonnet-5.5 (эталон) | 809 ₽ | — | 89,5% | — | — |
| qwen3.8 27B с рассуждениями, промпт сервиса | ~190 мин | — | — | — | — |
| qwen3.8 27B без рассуждений, промпт сервиса | 41 мин | 86% | 86,4% | 56 (41%) | 87,2 |
| Вариант 1: короткий ответ, шкала уверенности | 21 мин | 99% | 80,1% | 49 (41%) | — |
| Вариант 2: «чётко / искажено» вместо числа | 18 мин | 98% | 85,5% | 6 (50%) | 83,8 |
| Вариант 3: + подсказки к пяти правилам | 18 мин | 98% | 88,2% | 13 (62%) | 88,5 |
«Пригодность совпала» — доля диалогов, которые модель так же, как эталон, признала пригодными для разбора. Средний балл эталона — 92. Варианты 1–3 — последовательные доработки промпта для qwen3.8 27B без рассуждений.
По итогам замеров и оптимизации видим следующее:
- После отключения рассуждений и оптимизации промпта qwen3.8 27B ускорилась со 190 до 18 мин на день, то есть примерно до 7 с на диалог.
- Сначала нужно проверить, слышно ли начало и конец продажи. Если нет, лучше проставить «не применимо», а не записывать нарушение. Это надо учитывать в промптах.
- Нужны подсказки, как читать правила. Например, «хлебушка, сырочка по акции» — это предложение товара, а «колбаска на 349» при одной позиции — это перечисление чека.
После правки текстов самих правил совпадение с эталоном у claude-haiku-5.5 составило 85,3%, а у qwen3.8 27B — 88,5%.
Полный отчёт за день: время и деньги
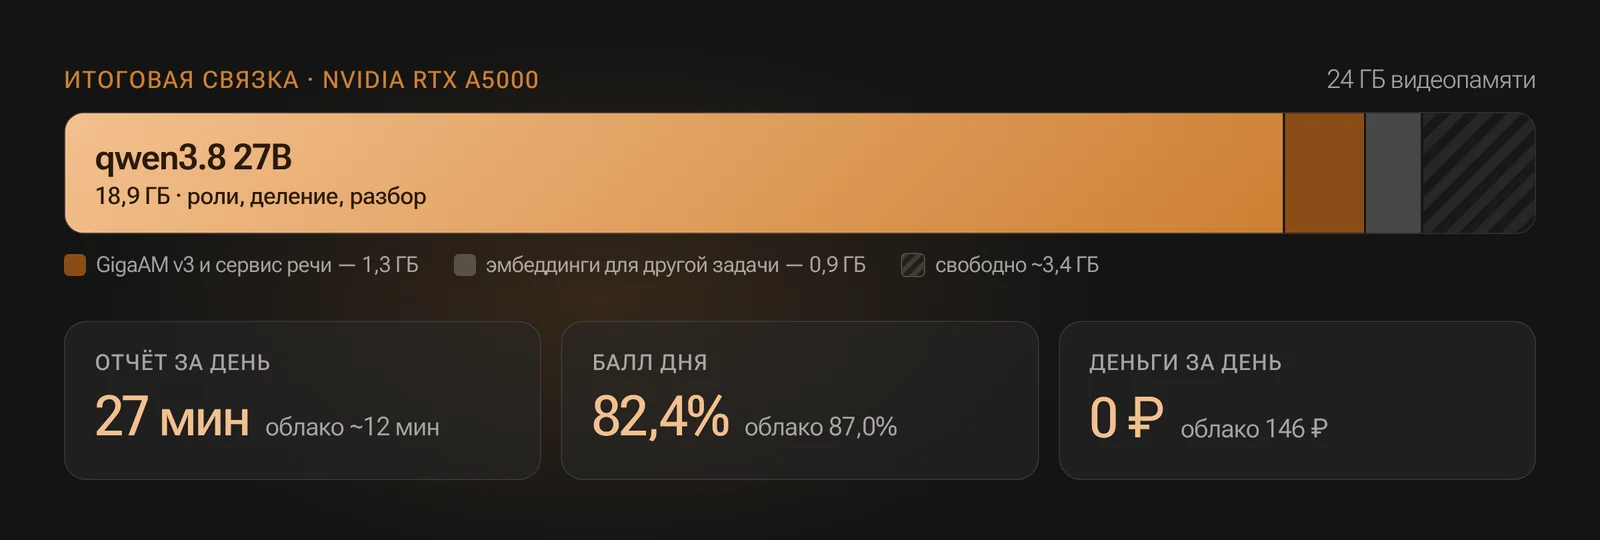
За четыре итерации локальный отчёт за выбранный день ускорился с 282 до 27 мин, а балл приблизился к облачному: 82,4% против 87,0%. Облако по-прежнему быстрее, но платное. Локальный отчёт стоит только электричества и вложений в оборудование. И максимум, что получится выжать из одной видеокарты, — обработка 30–40 магазинов в сутки. Тоже важный показатель.
Ниже — данные построения отчёта за один из дней: 156 записей, 174 мин звука.
| Облако | Итерация 1 | Итерация 2 | Итерация 3 | |
|---|---|---|---|---|
| Конфигурация | mai-transcribe-2, gpt-4.1-mini, claude-haiku-5.5 | GigaAM без настройки + qwen3.8 27B с рассуждениями | Whisper + qwen3.8 27B без рассуждений, промпты сервиса | GigaAM с настройкой + qwen3.8 27B без рассуждений, новые промпты |
| Расшифровка и роли | ~3 мин | 6 мин | 11 мин | 7,5 мин |
| Деление | ~2 мин | 81 мин | 8 мин | 3,3 мин |
| Разбор | ~7 мин | 194 мин | 35 мин | 16 мин |
| Всего | ~12 мин | 282 мин | 53 мин | 27 мин |
| Деньги | 146 ₽ | 0 ₽ | 0 ₽ | 0 ₽ |
| Балл дня | 87,0% | 72,6% | 76,5% | 82,4% |
| Предупреждений | 12 | 29 | 91 | 27 |
| Оценки совпали с облаком | — | 77% | 83% | 84% |
Шаги идут частично параллельно, поэтому их сумма не всегда равна итогу. В облаке одновременно идут до 6 запросов, а Ollama отвечает только на один запрос за раз.
Теперь данные замера за другой день: 174 разговора, 162 мин звука.
| Облако | Локально | |
|---|---|---|
| Время | 23,5 мин | 44,5 мин |
| из них расшифровка и роли / деление / разбор | — | 28 / 3,4 / 13 мин |
| Деньги | 128 ₽ | 0 ₽ |
| из них расшифровка / роли / деление / разбор | 50 / 9 / 20 / 50 ₽ | — |
| Диалогов / разобрано / исключено | 181 / 110 / 71 | 180 / 101 / 79 |
| Балл дня | 86,9% | 81,9% |
| Предупреждений | 4, все верные | 24: 11 верных, 7 ложных, 6 спорных |
Уверенные оценки облака и локальной модели совпали в 91,7% случаев (84 общих диалога).
Один магазин с одним микрофоном при обработке в облаке обходится примерно в 130–150 ₽ в день, то есть 4–4,5 тыс. ₽ в месяц. Расшифровка — около 40% этой суммы. claude-sonnet-5.5 вместо claude-haiku-5.5 обойдётся в 650–810 ₽ в день только за разбор. Локальная модель за 30 мин работы видеокарты при лимите 230 Вт потребляет ориентировочно 0,1–0,2 кВт·ч на отчёт. Но покупка оборудования окупается только на многих магазинах, а одна A5000 обрабатывает около 120–180 мин звука за 30 мин.
Подводя итоги
Прежде всего, мы убедились, что поставленную задачу вообще можно решать с помощью локальных моделей. Это важно, например, для компаний и организаций, которые не могут себе позволить работать с облачными моделями.
Есть ещё вариант использовать сервисы Yandex: у них одни из самых сильных моделей для ASR и облачные LLM с удовлетворительным качеством работы. Но для организаций, которые могут работать только в закрытом контуре, даже такой вариант подходит не всегда.
Рассуждения для модели — это не всегда хорошо. В нашем случае они повышают стоимость обработки примерно в 10 раз. Оптимизация промптов и отключение рассуждений позволили сократить время на разделение записей со 106 до 5 мин, а разбор — со 190 до 18 мин без потери качества. Рассуждения оставили только там, где запросов мало, например в перепроверке предупреждений.
Локальные модели без рассуждений не стоит просить о «сложных решениях». Лучше разложить запрос на простые факты («был ли расчёт до паузы», «что после паузы»).
Числовая уверенность моделей не заслуживает доверия. qwen3.8 27B без рассуждений ставит 80–100 на 99% оценок, а у claude-haiku-5.5 уверенность не отделяет верные нарушения от ложных. Работает либо категориальный вопрос («слышно чётко?»), либо порог, подобранный по эталону отдельно для каждого правила.
Промпты не переносятся между моделями. Лучший промпт для qwen3.8 27B на claude-haiku-5.5 дал 35% точности предупреждений вместо 50%.
В распознавании речи настройки подачи звука важнее выбора модели. Подъём громкости и порог тишины снизили ошибки GigaAM с 64% до 48% — сильнее, чем замена на Whisper. Публичные рейтинги на чистой речи плохо предсказывают результат на тихом разговоре у прилавка.
Подсказки распознаванию опасны для контроля. Лишняя «акция» в расшифровке — это засчитанное продавцу предложение, которого не было. Пропуск для нас безопаснее выдумки.
Как итог, мы останавливаемся на связке GigaAM v3 e2e RNNT и qwen3.8 27B.
Они прекрасно уживаются на одной видеокарте с 24 ГБ памяти. Это не конечный результат, а лишь промежуточный итог.
Полевые испытания ещё не закончились. Нам предстоит:
- Апробировать итоговую модель микрофона, которая только вчера доехала к нам из Китая. Надо написать и отладить для неё прошивку. Но штука занятная и в чём-то весёлая.
- Нормально спроектировать интерфейс сервиса и проработать процесс обработки замечаний от системы и учёта вердиктов от человека. Сервис должен продолжать обучаться на решениях живых людей.
- Уже прозвучали пожелания о панели контроля инцидентов. Сервис должен приносить бизнесу заметную пользу.
Если вы дочитали до конца и написанное было для вас полезным, то спасибо вам.