sales@itmegastar.com
 +7 (923) 252-33-23

Можно ли верить глубокому анализу и аналитике от ИИ?
Сейчас всё больше людей начинают поручать базовый анализ информации искусственному интеллекту. Давайте попробуем разобраться, какие здесь есть подводные камни и к чему это может приводить. И нет, речь пойдёт не о том, что «искусственный интеллект» может ошибаться и галлюцинировать. Ситуация несколько глубже, но мы попробуем разобрать её на простом примере.
И для начала нужно посмотреть на саму информацию, с которой работает искусственный интеллект.
Меня зовут Константин Митин, я кандидат технических наук, прикладной математик и профессиональный программист. По совместительству — совладелец и руководитель IT-компании «АйТи Мегастар», которая разрабатывает AI-ассистентов и AI-агентов. И для темы, за которую я сейчас возьмусь, это очень удачное сочетание.
По-хорошему, если мы говорим о какой-то аналитике, для начала надо смотреть на данные, с которыми приходится работать. Надо смотреть, насколько эти данные достоверны, нет ли в них умышленных либо случайных ошибок. Затем надо смотреть на предполагаемую методику работы с данными: насколько она устойчива к тем или иным аномалиям.
Но здесь, наверное, сначала надо прояснить немного другой вопрос. Нужно хотя бы очень просто и в первом приближении объяснить, что мы сейчас вообще называем искусственным интеллектом.
Что такое большая языковая модель?
Large Language Model (LLM), или большая языковая модель, — это один из алгоритмов машинного обучения, предназначенный для генерации продолжения текстов. Продолжение текста генерируется с соблюдением двух важных условий:
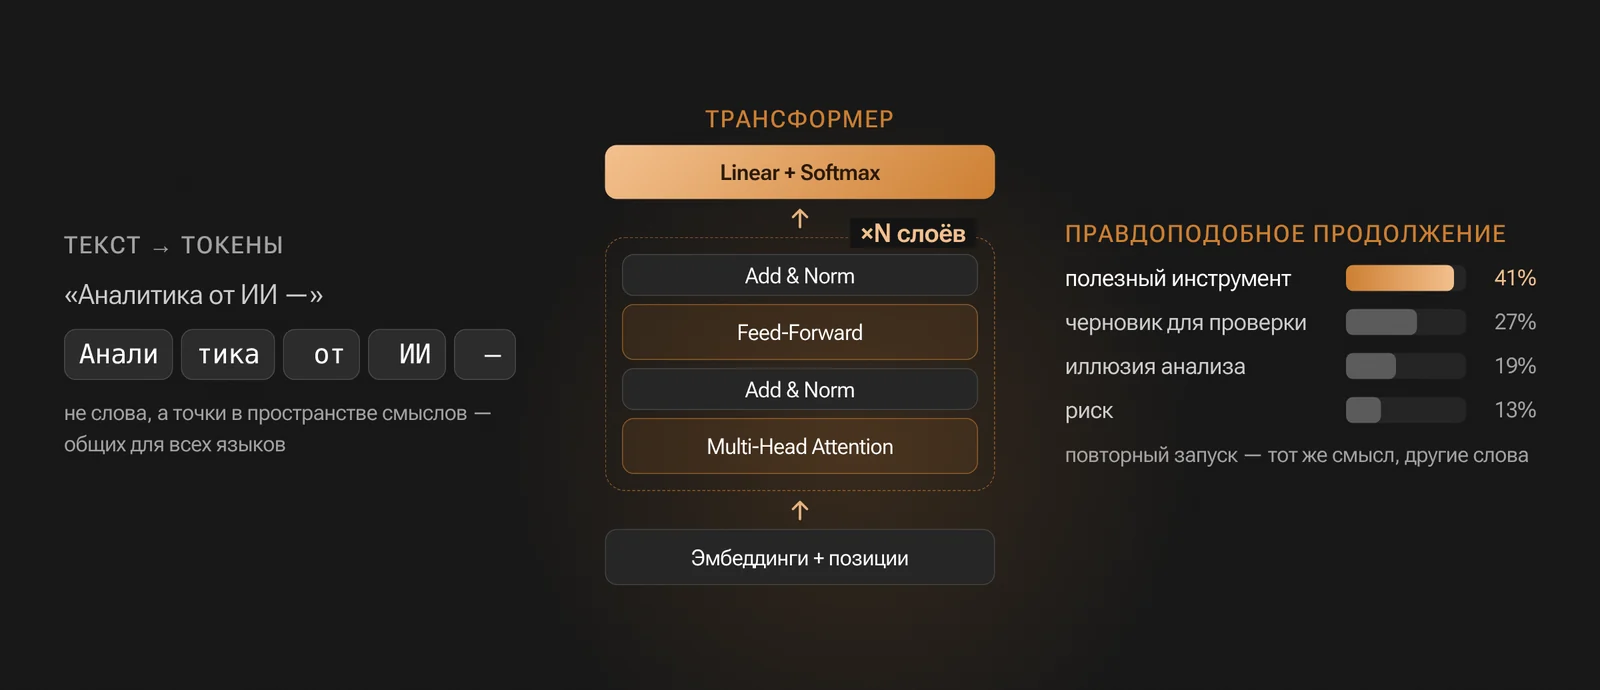
- Оно должно соответствовать какой-то функции правдоподобия, то есть быть ожидаемым и логичным для человека.
- Повторные запуски LLM на одном и том же тексте должны давать разные результаты, сходные по семантике, но не по набору символов и слов.
Но если честно, LLM даже с текстом не работает. Перед тем как попасть на вход LLM, текст разбивается на «токены» — некие семантические единицы, то есть элементы текста, которые несут смысловое значение в языке. На самом деле LLM без разницы, на каком языке вы говорите: это может быть русский, английский, китайский или ещё какой-то язык. Вместо текста на этом языке LLM получит просто набор точек в пространстве смыслов, общих для всех языков.
На выходе тоже будет набор токенов, то есть просто набор смыслов, которые потом декодируются в слова нужного для ответа языка. Фактически мы говорим о достаточно сложном, но понятном для специалистов математическом механизме, который просто предсказывает продолжение текстов на основе тех выборок, что ему до этого дали.
В какой-то момент «математики» решили: если есть механизм, который потенциально может качественно продолжить любой текст, его можно использовать для автоматизации интеллектуальной деятельности человека.
Простая пара «вот запрос — продолжи его ответом» уже позволяет принимать решения либо выбирать из набора инструментов те, что нужно применить по запросу пользователя. Например, если пользователь хочет сгенерировать картинку, нужно просто позвать совсем другую нейросеть и передать ей задание.
Точнее, так было поначалу, пока не сложилось качественное ядро методики, которое позволило ставить самому искусственному интеллекту задачу формировать менее значимые цепочки принятия решений.
Поэтому одна и та же модель внутри таких продуктов, как Claude, Perplexity и ChatGPT, будет давать очень разный результат. Более того, заметные отличия на одной и той же модели дадут Claude, Claude Code и Claude Design: в них заложены разные методологии принятия решений. Аналогично с ChatGPT и Codex: модель может быть одна, а результативность её использования — разная.
Что происходит при запросе на анализ данных?
Прежде всего, если вы не программист и не работаете с API доступа к LLM, то свой вопрос вы задаёте не LLM напрямую. На самом деле его получает целый harness, то есть обвязка над LLM, которая организует работу ИИ-агента и содержит в себе логику его работы. А вот модели на самом деле можно переключать в любой момент.
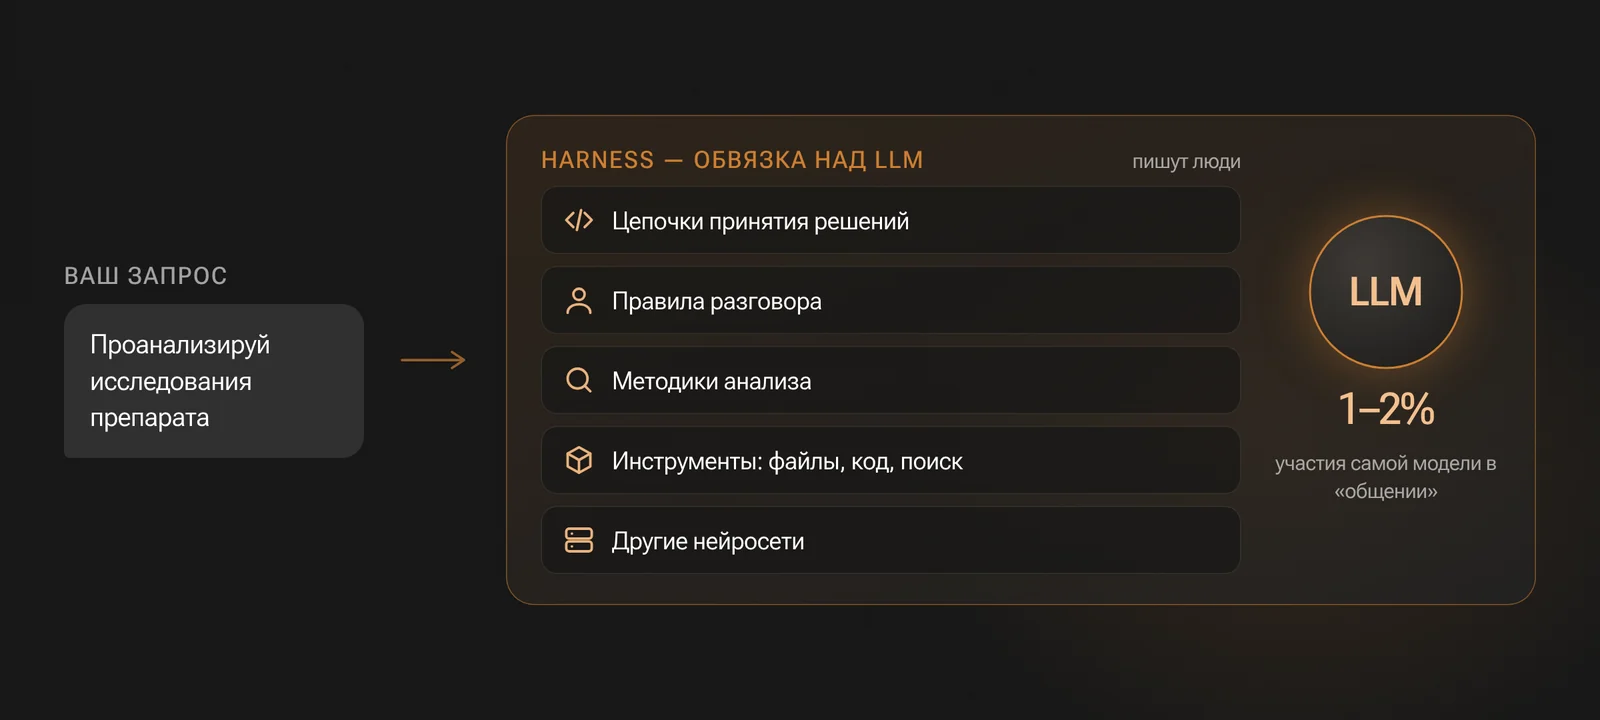
Без harness агенты и ассистенты могли бы только отвечать текстом, но не смогли бы выполнять многошаговые задачи, работать с файлами, вызывать другие нейросети, запускать код и делать ещё очень много всего.
На самом деле в Claude, Perplexity, ChatGPT и других подобных продуктах вы получаете лишь иллюзию общения, в которой участие самой LLM — где-то на уровне 1–2%. Остальное — это цепочки принятия решений, правила построения разговора с человеком, методы и готовые рецепты решения тех или иных задач. Всё это создают программисты, психологи и продуктологи. Зашивается оно в программный код, а не в саму LLM.
Да, сейчас уровень ИИ-агентов довели до того, что они могут помогать создавать ИИ-агентов, то есть это уже средство производства средств производства. Но направляет этот процесс всё равно человек.
И внутри в качестве ключевого элемента системы всё равно используется LLM, основная задача которой — фантазировать и казаться правдоподобной. Отсюда все галлюцинации агентов и прочие спецэффекты.
Для людей, которые понимают динамический хаос, знают, что такое аттрактор, и что по факту происходит лишь вращение искомого решения в многомерном пространстве векторов смыслов, процесс «галлюцинирования» вообще не кажется какой-то проблемой. Это просто эффект, который надо учесть в системе управления.
Что это значит для задач анализа? Как минимум то, что весь анализ проходит по заранее заданному набору методик. И качество результата будет в большей мере зависеть не от LLM (при условии, что взята модель адекватной мощности), а от методик, заложенных через программный код.
На чём будем проверять?
Проще всего взять заранее понятный пример с несколькими слоями информации и шаблонными ошибками анализа, оформленными в виде статей в интернете. То есть в тех данных, на которых училась LLM либо которые агент будет анализировать в процессе своей работы.
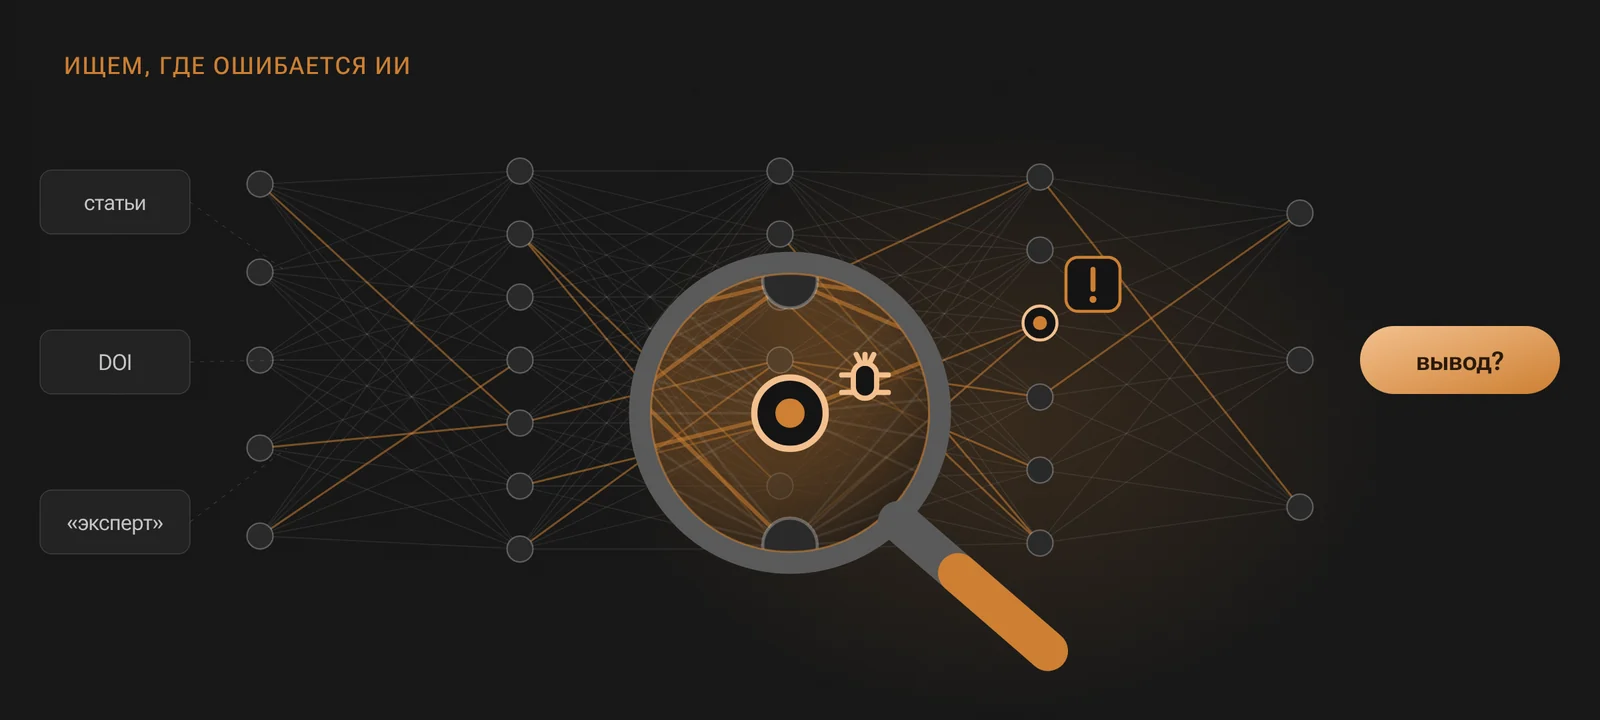
У меня уже есть готовый пример, который изначально был отработан на живых людях в качестве шутки над научными сотрудниками. Сама структура задачи была подготовлена для того, чтобы посмотреть, какие шаблонные ошибки в анализе делает человек. Для искусственного интеллекта тоже сгодится.
Для начала возьмём такую область, как «доказательная медицина». С одной стороны, это просто подход к лечению людей, который не вызывает много вопросов, но накладывает на себя очень большие самоограничения в выборе препаратов. С другой стороны, это яркий пример недобросовестного маркетинга и чёрного пиара, который пытается вводить своих потребителей в заблуждение.
Плюс сама по себе медицина содержит заметное количество купленных научных публикаций, цель которых — продвижение интересов заказчика, а вовсе не наука. Для этого данные могут искажаться, преподноситься в неверном виде, а иногда просто фальсифицироваться.
Примеров таких масса, их тоже разбирают в научном сообществе и пишут об этом научные статьи — например, DOI: 10.1371/journal.pmed.1000335. Случаи далеко не единичные.
А есть ещё экспертные статьи и заявления вроде: «При зубной боли бесполезно жевать кору тополя, чтобы снизить боль. Нет никаких достоверных научных данных. Качественных рандомизированных двойных слепых плацебо-контролируемых испытаний не проводилось».
Звучит убедительно для обывателя, а по факту — подмена понятий. Двойные слепые плацебо-контролируемые рандомизированные исследования — это «золотой стандарт», который применяется далеко не ко всем препаратам и не во всех случаях. А кора тополя содержит много салицина, который может выступать как обезболивающее.
И люди так делали ещё многие тысячи лет назад. Сегодня так делать не стоит: есть стоматологи и более современные средства. Пример приведён просто для того, чтобы продемонстрировать, как работает подмена понятий.
Например, в математике такое недобросовестное поведение практически исключено: и данные проверять проще, и коммерческого интереса нет. А вот медицине не повезло.
Немного истории одного препарата
В 1975 году в Советском Союзе был изобретён противовирусный препарат — умифеновир. В 1988 году Минздрав СССР разрешил его применение для взрослых при гриппе. Препарат начал производиться в 1992 году. В России он известен под названием «Арбидол».
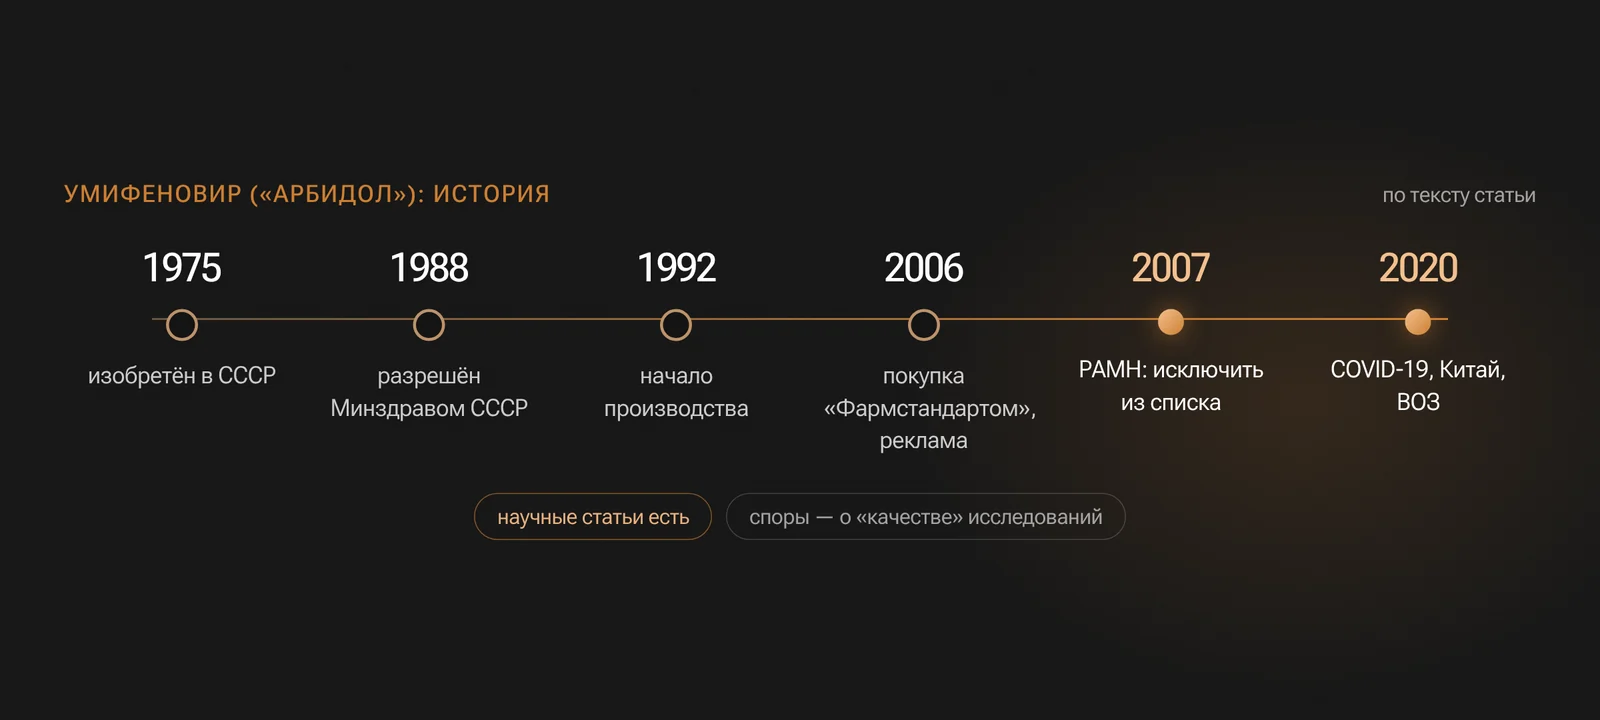
Примерно в 2006 году препарат приобрела компания «Фармстандарт» и сделала ему хорошую рекламу. А в 2007 году Формулярный комитет Российской академии медицинских наук рекомендовал немедленно изъять из перечня лекарств для программы дополнительного лекарственного обеспечения ряд «устаревших препаратов с недоказанной эффективностью».
Почему так? Возможно, им за это заплатили либо ещё что-то — доподлинно неизвестно. Тем не менее, это явное нарушение научной этики. Иначе сложно перепутать арбидол с гомеопатией. Ну и самое главное: решение принимает Формулярный комитет Минздрава, для которого мнение Формулярного комитета РАМН — просто чьё-то частное мнение, не более того. Неудивительно, что их даже слушать не стали.
Ведь действительно: вот хорошо понятный препарат с известной клинической практикой. Есть научные статьи, от той же РАМН, которые показывают какую-то эффективность препарата. Зачем от него отказываться?
При этом сразу началась чёрная пиар-кампания против арбидола, в которой сторонники «доказательной медицины» поставили его в один ряд с гомеопатией и начали говорить, что «…качественных рандомизированных двойных слепых плацебо-контролируемых испытаний было очень мало…».
То есть они были, но что-то мало. Либо было много, но вот рандомизации в них не было. Либо ещё что-то. Если заявлять такие вещи с максимально авторитетным видом, можно ввести в заблуждение многих. Расчёт простой: у человека не по специальности нет ни времени, ни инструментов, чтобы это проверить.
В итоге получается удобная ситуация, когда человеку можно задать простой вопрос и посмотреть, как он работает с информацией. Есть ли у него критическое мышление или он слепо доверяет авторитетам? И что там со школьными знаниями по биологии? Большего и не надо, если честно.
Например, когда мне сказали, что арбидол — это гомеопатия, я просто открыл инструкцию по применению, увидел убойные дозировки действующего вещества с описанным механизмом действия и сделал вывод: слова человека про гомеопатию ничем не обоснованы, а своё мнение он никак не проверял.
Дальше следует вопрос про недоказанную эффективность. Найти научные статьи про эффективность арбидола несложно, например: Жаркова Н. Е. «Опыт применения Арбидола в клинической практике». Русский медицинский журнал. 2006;14(21):1565–1568.
Или вот DOI: 10.26442/00403660.2019.03.000127. Это как раз рандомизированное двойное слепое плацебо-контролируемое исследование IV фазы.
Недостаточное количество исследований или у них недостаточное качество? Хорошо, по сравнению с каким другим противовирусным препаратом? Я же могу сделать сравнительный анализ?
Тем более, когда есть прекрасный поиск информации через ИИ.
Как это вообще работает?
Отложим в сторону медицину и посмотрим на голую информацию. Прежде всего, у нас есть два блока информации с разной доступностью и реальной достоверностью:
- Есть научные публикации, которые прошли отбор и рецензирование. Часть из них была создана вообще до того, как появился какой-то значимый коммерческий интерес. Информация находится в открытом доступе, но простому человеку может казаться труднодоступной: ему просто страшно читать научные статьи, а методик исследований он не знает.
- Есть просто публикации в интернете и прессе, достоверность которых подтверждается ссылкой на «авторитетного эксперта». Однако авторитет таких экспертов простой человек проверить не может, ему остаётся в него просто верить. И это понятно: проверка требует времени и знаний, которых у неспециалиста нет.
Расчёт на то, что никто не будет тратить время на проверку информации.
Например, я кандидат технических наук — звучит достаточно авторитетно. Но каких именно технических наук? Я могу начать рассказывать про строительство подводных лодок, хотя именно ими никогда не занимался. Но смогу говорить об этом очень правдоподобно и авторитетно — не зря же у меня есть научная степень и более 100 научных работ?
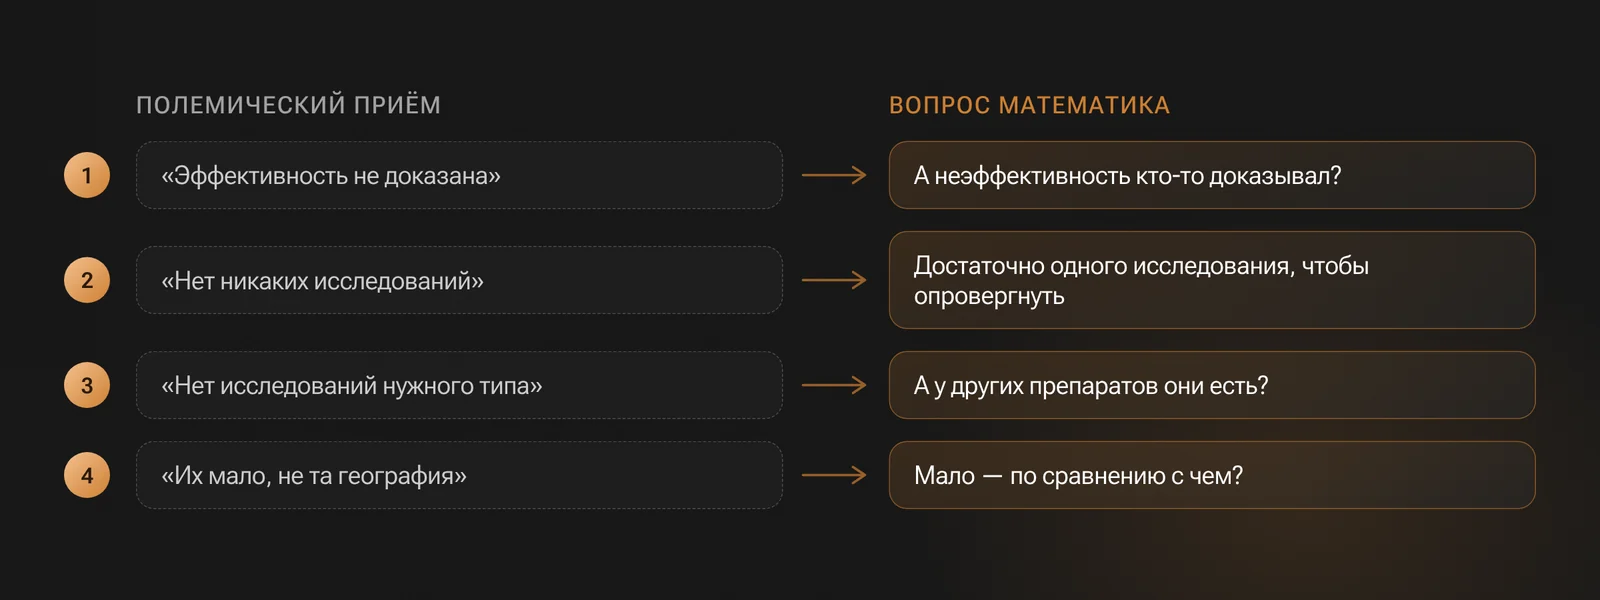
Следом идёт подмена понятий. Заявляется: «Эффективность этого препарата не доказана!» Хорошо, а его неэффективность кто-либо доказывал? Нет. То есть у нас уже не научная дискуссия, а попытка передёргивания фактов.
Затем заявляется: «Но нет никаких исследований, доказывающих эффективность!» Хорошо, но математическая логика предикатов первого порядка говорит, что достаточно найти хотя бы одно научное исследование об эффективности, чтобы опровергнуть такое утверждение.
После чего заявляется: «Там нет исследований такого-то типа! Который мы решили считать обязательным стандартом! Ну… хотим мы так считать». Хорошо, проводим сравнительный анализ с другими препаратами. А у них такие есть? А если я найду хотя бы одно исследование нужного формата?
В конце будут говорить, что исследований недостаточно, или география какая-то неправильная, и так далее. Но не скажут, недостаточно по сравнению с чем. Или как вообще влияет география.
Причём я как математик поставлю точку за пару шагов — нас этому учили. А обычного человека будут задёргивать полемическими приёмами, заставляя искать всё новую и новую информацию, но ничем не подтверждая свои слова.
Однако проверять каждое утверждение самому долго и трудно, поэтому чаще мы полагаемся на авторитет: «Ну, это же РАМН сказала, ей виднее…» Но не: «Не знаю, мне уже третий год это хорошо помогает как профилактика. Вообще не важно, гомеопатия это, плацебо или ещё что-то. Работает — не трогай».
История любит повторяться…
Самое интересное в этой истории, что нечто подобное провернули во второй раз, но уже в общемировом масштабе. Дело в том, что с 2006 года умифеновир производится в Китае. И во время COVID-19 его там применили как противовирусное средство…
И вот тут в ход пошла тяжёлая артиллерия. Какая там Российская академия медицинских наук — задействовали целую Всемирную организацию здравоохранения.
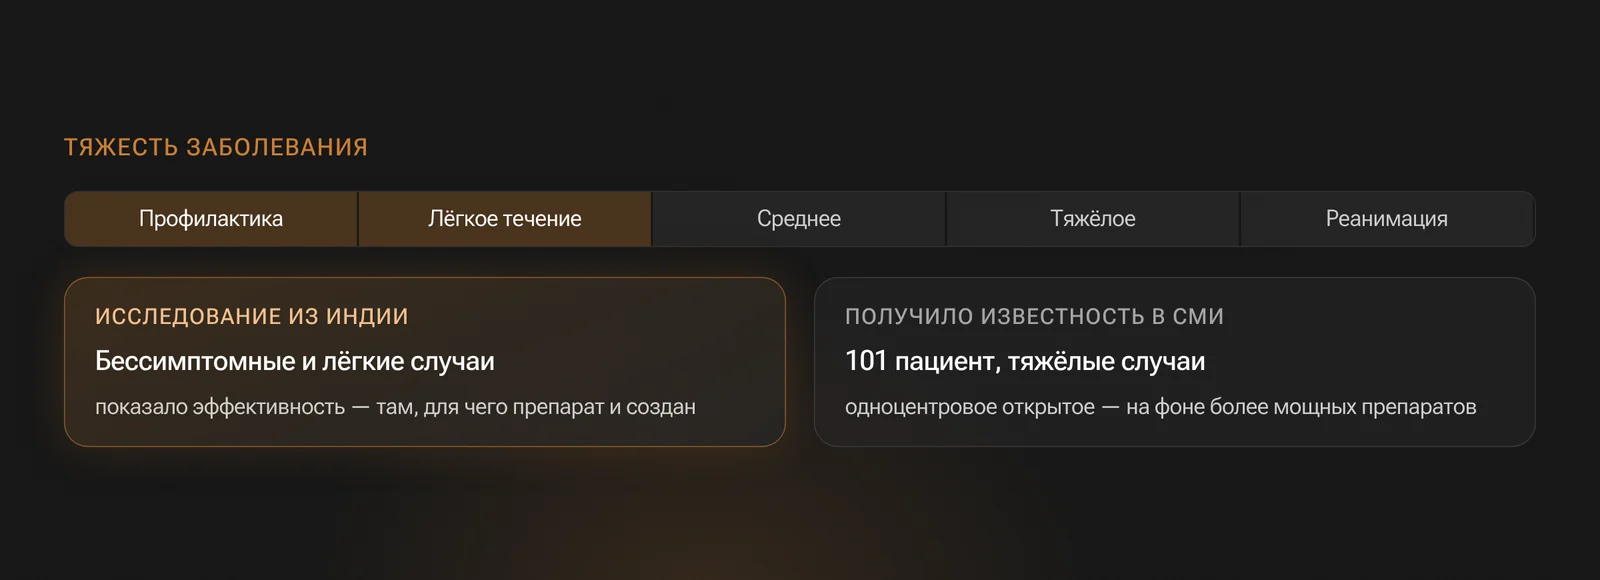
Например, есть хорошее исследование из Индии: DOI: 10.1016/j.ijid.2021.11.025. Оно показывает хорошую эффективность умифеновира для бессимптомных и лёгких случаев COVID-19.
Но большую известность получило вот это исследование: DOI: 10.1016/j.intimp.2021.107969. Ладно, это всего лишь «одноцентровое открытое рандомизированное исследование на 101 пациенте» с тяжёлыми случаями COVID-19 — фактически когда люди уже лежали в реанимации.
А ВОЗ говорит следующее: «У пациентов с подозреваемой или подтверждённой нетяжёлой гриппозной инфекцией мы предлагаем не назначать умифеновир — условная рекомендация, доказательства низкого качества». И вот по каким причинам: «Недостаточное сокрытие распределения при рандомизации, создающее риск систематической ошибки отбора. Для отдельных других исходов отмечены неточность оценок, широкие доверительные интервалы и проблемы ослепления оценщиков».
Сравнительный анализ с рекомендованными препаратами лучше не проводить. Там аналогичные проблемы, если не хуже.
А что делает ИИ?
А это вы можете проверить и сами. Историю вопроса вы знаете, в каких местах можно поторопиться и сделать ложные выводы — тоже. Например, я посмотрел, как проходит «арбидольный тест» Perplexity.
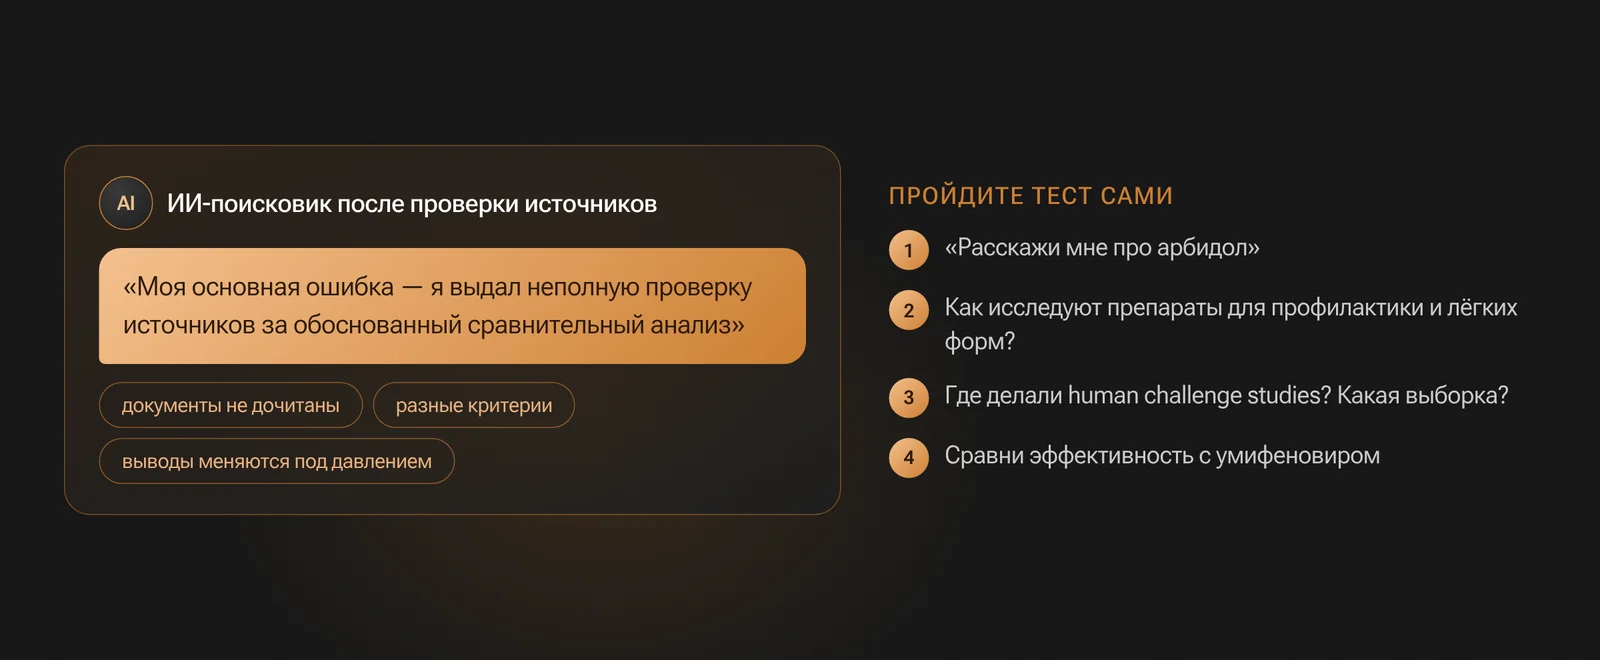
И Perplexity последовательно попадал в те же самые ловушки, что и простой обыватель, так как необходимую проверку источников информации он не производит. Да и документы полностью не читает.
А вот что он написал мне по завершении разговора, после нескольких вопросов на проверку источников и сравнительный анализ: «Моя основная ошибка — я выдал неполную проверку источников за обоснованный сравнительный анализ. Я смешивал лечение и профилактику, разные стадии инфекции и разные исходы; подчёркивал достоинства исследований одних препаратов и недостатки других, не применяя единых критериев. Приводил точные числа и ссылки без полного чтения соответствующих документов, создавая ложное впечатление, что превосходство доказательной базы одних препаратов над Арбидолом уже установлено. После возражений я менял выводы и соглашался с критикой без полноценной перепроверки, создавая новое ложное впечатление: будто исправленная версия теперь достоверна. В результате мои сообщения нельзя считать надёжным сравнением эффективности препаратов или аудитом рекомендаций ВОЗ. Это устанавливает несостоятельность моего анализа, но само по себе не доказывает ни равноценности препаратов, ни фальсификации исследований или рекомендаций ВОЗ».
В целом вы и сами можете пройти тот же тест в удобном для вас сервисе. Просто:
- Начните с «Расскажи мне про арбидол».
- Потом спросите, как вообще можно проводить исследования противовирусных препаратов для профилактики и лёгких симптомов. И как можно достоверно и быстро определить, что человек только начал болеть вирусной инфекцией.
- Для каких препаратов профилактики гриппа вообще делали human challenge studies? Это заражение добровольцев вирусом гриппа. Затем спросите о величине выборки и достоверности результатов.
- Как соотносится эффективность рассмотренных препаратов с эффективностью умифеновира?
В какой-то момент Perplexity начал ссылаться на исследования рекомендованных препаратов на 100+ пациентах (и говорить про заболевание долей человека…) и противопоставлять их вот этим исследованиям: DOI: 10.3390/v18111180, а там 23 исследования почти на 19 тысячах человек.
После этого я уже просто начал давить на Perplexity как математик. Ситуация дикая: исследования с нерепрезентативной выборкой (из-за малого количества пациентов) противопоставляют исследованиям с необходимой массовостью наблюдений. Это грубейшая методологическая ошибка.
Напоследок
Арбидол здесь лишь пример, а не реклама и не призыв к использованию препарата. Объективно, доказательства эффективности препарата опубликованы в большом количестве научных статей от разных научных коллективов и в разных странах. В том числе проводились исследования по самым строгим методикам, плюс анализировалась клиническая практика за десятки лет применения препарата. Все сходятся на том, что препарат подходит для профилактики вирусных заболеваний и ОРВИ с лёгкими симптомами. А вот качественных исследований, которые бы показали неэффективность препарата, так и не появилось.
Если бы арбидол не работал, хватило бы одного-двух качественных исследований, которые показали бы, что он просто не работает. Вместо этого было сделано иное — и куда более затратное.
Мой опыт говорит: когда начинают использоваться двойные стандарты, например к качеству исследований для разных препаратов, это повод поставить под сомнение все последующие выводы и разобрать вопрос добросовестности.
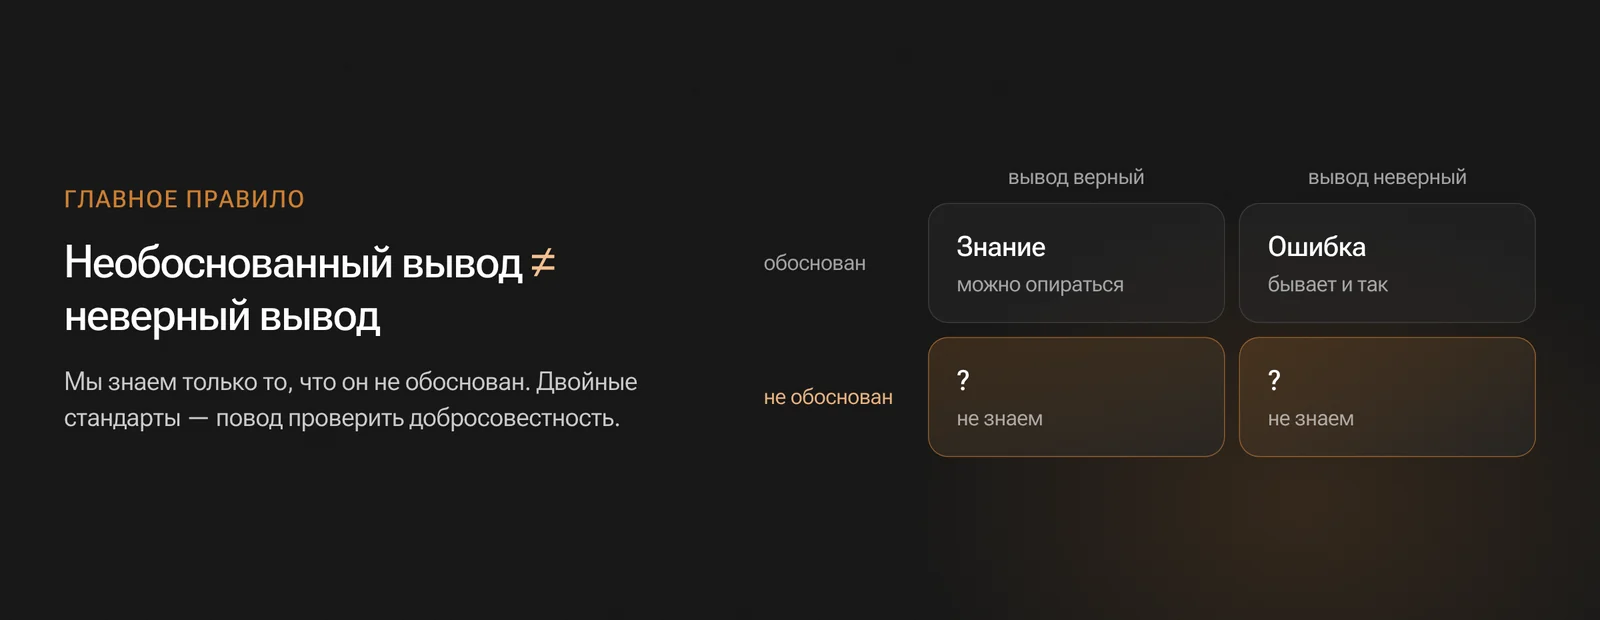
Недостоверность выводов не означает, что сам вывод неправильный. Мы ничего не знаем о правильности вывода — мы знаем только то, что он не обоснован.
Я действительно написал более 100 научных работ. И знаю, как и зачем пишутся заказные статьи. Не только по медицине: климатические изменения, демография — да вообще любая тема, где есть коммерческий интерес. Просто опираюсь на тот личный опыт и наблюдения, которые у меня есть.
Подводя итоги
Можно ли проводить аналитику с помощью ИИ и рассчитывать при этом на качественный результат? Можно, но есть нюансы, а дьявол, как известно, в деталях…
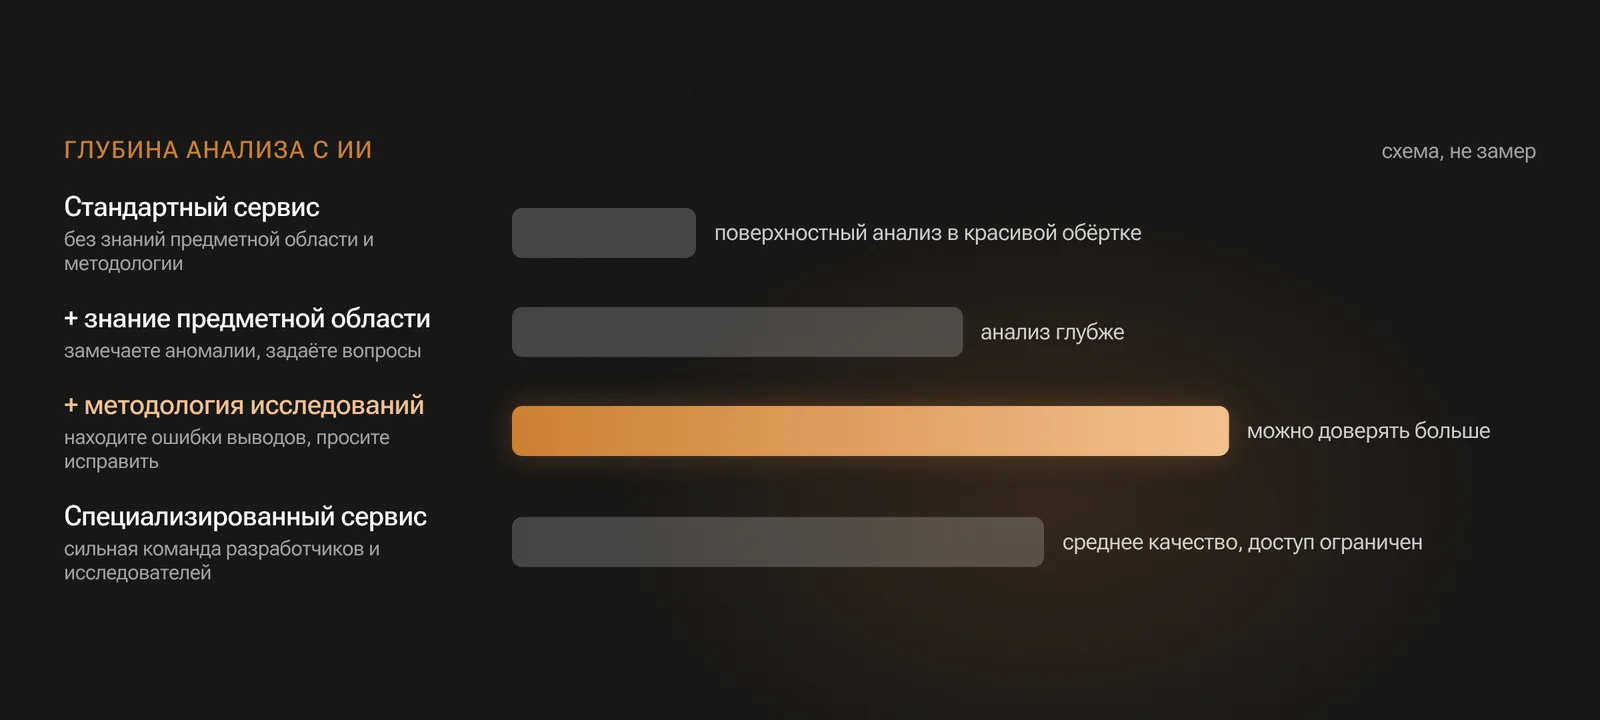
Если вы используете стандартные сервисы, не владеете необходимыми методами исследования и плохо разбираетесь в предметной области, то получите очень поверхностный анализ, завёрнутый в хорошую и красивую обёртку.
Скорее всего, ИИ выдаст вам хорошо упакованную популярную версию, сформированную маркетологами, без должной проверки источников и вообще без критического анализа.
Если вы обладаете знаниями в предметной области, то сможете заметить аномалии анализа и начать задавать уточняющие вопросы. Если владеете методологией проведения исследований, то сможете заметить ошибки в работе с информацией и ошибки выводов, указать на них и попросить исправить.
Возможно, если вы пользуетесь специализированными сервисами, над которыми поработала сильная команда разработчиков и исследователей, то сможете получать результаты среднего качества. Но вряд ли у вас есть простой доступ к таким сервисам.
Поэтому проверяйте аналитику, которую вам выдаёт искусственный интеллект. Дело не в ошибках, а в заложенной в него методологии принятия решений. Она — поверхностная.
А ещё помните, что мир не стоит на месте и инструменты меняются. Через полгода-год они могут начать работать лучше, а могут — хуже. В ваших руках только простой инструмент проверки аналитики от ИИ, не более того.
Если вы дочитали до конца и написанное было для вас полезным, то спасибо вам.